

कोर्स
डेटा इंजीनियरिंग को समझना
2 घंटा
377.4K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंApache Kafka एक ओपन-सोर्स डिस्ट्रीब्यूटेड इवेंट-स्ट्रीमिंग फ्रेमवर्क है, जिसे LinkedIn में Jay Kreps, Jun Rao, और Neha Narkhede सहित टीम ने विकसित किया। इस टूल को रियल टाइम में स्ट्रीमिंग डेटा को इन्गेस्ट और प्रोसेस करने के लिए अनुकूलित किया गया है; इसलिए, इसका उपयोग हाई-परफॉर्मेंस डेटा पाइपलाइंस, स्ट्रीमिंग एनालिटिक्स एप्लिकेशंस, और डेटा इंटीग्रेशन सेवाओं के कार्यान्वयन के लिए किया जा सकता है।
इवेंट्स को स्टोर करने के बाद, इवेंट स्ट्रीमिंग प्लेटफ़ॉर्म उन्हें संबंधित सेवाओं तक पहुँचाता है। डेवलपर ऐसे सिस्टम को अन्य सेवाओं पर निर्भर हुए बिना स्केल और मेंटेन कर सकते हैं। चूँकि Kafka एक ऑल-इन-वन पैकेज है जिसे मैसेज ब्रोकर्स, इवेंट स्टोर, या स्ट्रीम प्रोसेसिंग फ्रेमवर्क के रूप में इस्तेमाल किया जा सकता है, यह ऐसी आवश्यकताओं के लिए उत्कृष्ट रूप से काम करता है।
उच्च थ्रूपुट और टिकाऊपन के साथ, सैकड़ों डेटा स्रोत एक साथ निरंतर डेटा स्ट्रीम्स का बड़ा प्रवाह प्रदान कर सकते हैं, जिन्हें Apache Kafka के मैसेज ब्रोकर्स सिस्टम द्वारा अनुक्रम में और क्रमिक रूप से प्रोसेस किया जा सकता है।
Kafka कई मौलिक तरीकों से RabbitMQ जैसे पारंपरिक मैसेज ब्रोकर्स से भिन्न है:
| फ़ीचर | Apache Kafka | पारंपरिक ब्रोकर्स (जैसे RabbitMQ) |
|---|---|---|
| संदेश रिटेंशन | कंफिगरेबल (दिनों से वर्षों तक); उपभोग के बाद भी संदेश बने रहते हैं | कंज़्यूमर की स्वीकृति के बाद संदेश हटा दिए जाते हैं |
| कंज़्यूमर मॉडल | पुल-आधारित; कंज़्यूमर अपनी गति से पढ़ते हैं | पुश-आधारित; ब्रोकर्स कंज़्यूमर को डिलीवर करते हैं |
| थ्रूपुट | प्रति सेकंड लाखों संदेश | हजारों से लेकर दसियों हजार प्रति सेकंड |
| ऑर्डरिंग | एक पार्टिशन के भीतर गारंटीड | इंप्लीमेंटेशन पर निर्भर |
| रीप्ले | कंज़्यूमर किसी भी ऑफसेट पर पुराने संदेश फिर से पढ़ सकते हैं | डिलीवरी के बाद समर्थित नहीं |
| प्राथमिक उपयोग | इवेंट स्ट्रीमिंग, लॉग एग्रीगेशन, रियल-टाइम पाइपलाइंस | टास्क क्यूज़, रिक्वेस्ट-रिप्लाई पैटर्न |
Apache Kafka के प्रमुख लाभ शामिल हैं:
Kafka की सुडौल आर्किटेक्चर—जिसमें डेटा पार्टिशनिंग, बैच प्रोसेसिंग, ज़ीरो-कॉपी तकनीकें, और अपेंड-ओनली लॉग्स शामिल हैं—उसे उच्च थ्रूपुट हासिल करने और प्रति सेकंड लाखों संदेशों को संभालने में सक्षम बनाती है, जो उच्च-गति और उच्च-वॉल्यूम परिदृश्यों के लिए उपयुक्त है। इस प्रकार, हल्का कम्युनिकेशन प्रोटोकॉल जो प्रभावी क्लाइंट-ब्रोकर इंटरैक्शन को सक्षम करता है, रियल-टाइम डेटा स्ट्रीमिंग को संभव बनाता है।
Apache Kafka किसी टॉपिक को कई पार्टिशन में विभाजित करके सर्वरों के बीच लोड बैलेंसिंग प्रदान करता है। यह उपयोगकर्ताओं को उत्पादन क्लस्टर्स को भौगोलिक क्षेत्रों या उपलब्धता ज़ोन्स में वितरित करने और आवश्यकता अनुसार स्केल अप या डाउन करने में सक्षम बनाता है। दूसरे शब्दों में, Apache Kafka को आसानी से इस स्तर तक स्केल किया जा सकता है कि वह बड़ी संख्या में पार्टिशन में प्रतिदिन ट्रिलियनों संदेशों को संभाल सके।
Apache Kafka डीकपल्ड डेटा स्ट्रीम्स का उपयोग करते हुए कम विलंबता (2 मिलीसेकंड तक) वाले सर्वरों के क्लस्टर पर काम करता है, जिससे नेटवर्क-सीमित थ्रूपुट पर संदेशों की कुशल डिलीवरी संभव होती है।
Apache Kafka दो प्रमुख तरीकों से डेटा फॉल्ट-टॉलरेंस और टिकाऊपन को बढ़ाता है:
क्लस्टर-आधारित ब्रोकर्स के कारण, सर्वर आउटेज के दौरान भी Kafka काम करता रहता है। ऐसा इसलिए संभव है क्योंकि जब किसी सर्वर में समस्या आती है, Kafka पर्याप्त स्मार्ट है कि वह क्वेरीज़ को अन्य ब्रोकर्स की ओर भेज देता है।
Apache Kafka उपयोगकर्ताओं को रियल-टाइम में डेटा का विश्लेषण करने, रिकॉर्ड्स को उनके निर्मित क्रम में स्टोर करने, और उन्हें प्रकाशित व सब्सक्राइब करने में सक्षम बनाता है।
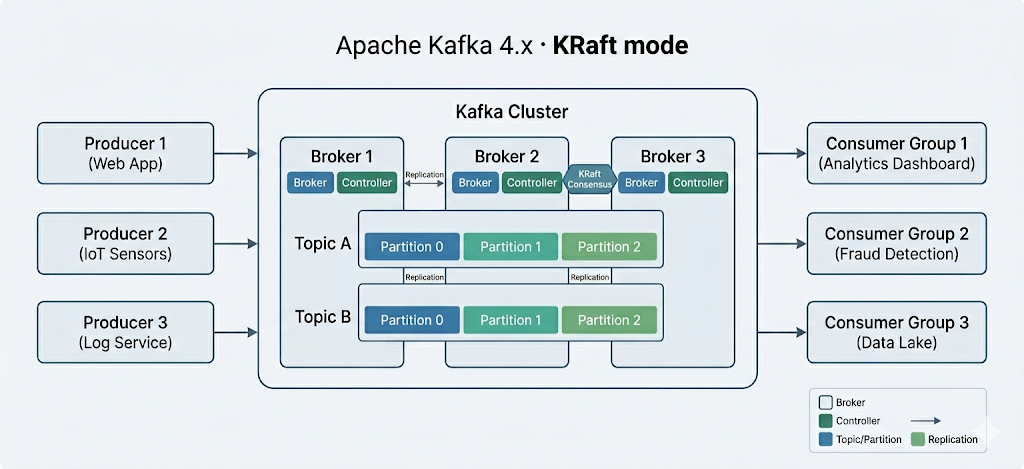
Apache Kafka के मुख्य घटक
Apache Kafka कमोडिटी सर्वरों का क्षैतिज रूप से स्केलेबल क्लस्टर है, जो कई "प्रोड्यूसर" सिस्टम्स और एप्लिकेशंस (जैसे लॉगिंग, मॉनिटरिंग, सेंसर और Internet of Things एप्लिकेशंस) से रियल-टाइम डेटा प्रोसेस करता है और बहुत कम विलंबता पर कई "कंज़्यूमर" सिस्टम्स और एप्लिकेशंस (जैसे रियल-टाइम एनालिटिक्स) को उपलब्ध कराता है—जैसा कि ऊपर के आरेख में दिखाया गया है।
ध्यान दें कि रियल-टाइम डेटा प्रोसेसिंग और एनालिटिक्स सिस्टम्स पर निर्भर एप्लिकेशंस दोनों को कंज़्यूमर माना जा सकता है। उदाहरण के लिए, लोकेशन-आधारित माइक्रोमार्केटिंग या लॉजिस्टिक्स के लिए कोई एप्लिकेशन।
Kafka के मुख्य घटकों को बेहतर समझने के लिए कुछ प्रमुख शब्द इस प्रकार हैं:
महत्वपूर्ण (2025 अपडेट): मार्च 2025 में जारी Apache Kafka 4.0 ने मेटाडेटा प्रबंधन के लिए KRaft (Kafka Raft) मोड को अपनाते हुए ZooKeeper को पूरी तरह हटा दिया है। नीचे दिए गए सेटअप निर्देश ZooKeeper का उपयोग करते हैं और केवल Kafka 3.x पर लागू होते हैं। Kafka 4.x के लिए ZooKeeper की अब आवश्यकता नहीं है और न ही वह समर्थित है। यदि आप नए सिरे से शुरू कर रहे हैं, तो सरल सेटअप के लिए KRaft मोड के साथ Docker का उपयोग करने पर विचार करें।
अक्सर अनुशंसा की जाती है कि सर्वोत्तम संगतता के लिए Apache Kafka 3.x को Zookeeper के साथ शुरू किया जाए। साथ ही, Windows पर इंस्टॉल किए जाने पर Kafka कई समस्याओं में पड़ सकता है क्योंकि यह इस ऑपरेटिंग सिस्टम के लिए स्वाभाविक रूप से डिज़ाइन नहीं किया गया है। परिणामस्वरूप, Windows पर WSL2 या Docker का उपयोग करके Apache Kafka लॉन्च करने की सलाह दी जाती है।
Windows पर JVM का उपयोग करके Kafka चलाने की सलाह नहीं दी जाती है क्योंकि इसमें Linux के विशिष्ट कुछ POSIX गुण उपलब्ध नहीं हैं। यदि आप WSL2 के बिना Windows पर Kafka चलाने का प्रयास करते हैं, तो अंततः आपको कठिनाइयों का सामना करना पड़ेगा।
यह कहते हुए, Windows पर Apache Kafka इंस्टॉल करने का पहला चरण WSL2 इंस्टॉल करना है।
WSL2, यानी Windows Subsystem for Linux 2, आपके Windows PC को बिना वर्चुअल मशीन के Linux वातावरण तक पहुँच देता है।
अधिकांश Linux कमांड WSL2 के साथ संगत हैं, जिससे Kafka की इंस्टॉलेशन प्रक्रिया Mac और Linux के निर्देशों के और करीब हो जाती है।
टिप: WSL2 इंस्टॉल करने से पहले सुनिश्चित करें कि आप Windows 10 संस्करण 2004 या उच्चतर (बिल्ड 19041 और उच्चतर) चला रहे हैं। Windows लोगो कुंजी + R दबाएँ, “winver” टाइप करें, फिर अपना Windows संस्करण देखने के लिए OK पर क्लिक करें।
Windows Subsystem for Linux (WSL) इंस्टॉल करने का सबसे आसान तरीका है कि एडमिनिस्ट्रेटर PowerShell या Windows Command Prompt में निम्न कमांड चलाएँ और फिर अपने कंप्यूटर को रीस्टार्ट करें:
wsl --installध्यान दें कि आपको अपने नए इंस्टॉल किए गए Linux डिस्ट्रिब्यूशन के लिए एक यूज़र अकाउंट और पासवर्ड बनाने के लिए कहा जाएगा।
यदि आप अटक जाएँ, तो Microsoft Docs वेबसाइट पर दिए गए चरणों का पालन करें।
यदि आपके मशीन पर Java इंस्टॉल नहीं है, तो आपको नवीनतम संस्करण डाउनलोड करना होगा।
इस अपडेट के समय, Apache Kafka का नवीनतम स्थिर संस्करण 4.2.0 है, जो फरवरी 2026 में जारी हुआ। Kafka 4.0 (मार्च 2025) ने मेटाडेटा प्रबंधन के लिए ZooKeeper की जगह KRaft मोड अपनाया। वर्तमान स्थिर संस्करण के लिए डाउनलोड पेज देखें।
नवीनतम संस्करण बाइनरी डाउनलोड्स से डाउनलोड करें।
डाउनलोड पूरा होने पर, उस फ़ोल्डर पर जाएँ जहाँ Kafka डाउनलोड हुआ है और ज़िप्ड फ़ोल्डर से सभी फ़ाइलें एक्सट्रैक्ट कर लें। ध्यान दें कि हमने अपने नए फ़ोल्डर का नाम “Kafka” रखा है।
Apache Kafka 3.x में क्लस्टर प्रबंधन के लिए Zookeeper आवश्यक है। इसलिए, Kafka से पहले Zookeeper को लॉन्च करना होगा। Zookeeper को अलग से इंस्टॉल करना आवश्यक नहीं है क्योंकि यह Apache Kafka का हिस्सा है।
कमांड प्रॉम्प्ट खोलें और Kafka की रूट डायरेक्टरी पर जाएँ। वहाँ पहुँचने के बाद, Zookeeper शुरू करने के लिए निम्न कमांड चलाएँ:
.\bin\windows\zookeeper-server-start.bat .\config\zookeeper.propertiesएक और कमांड प्रॉम्प्ट खोलें और Apache Kafka की रूट से निम्न कमांड चलाकर Apache Kafka शुरू करें:
.\bin\windows\kafka-server-start.bat .\config\server.propertiesटॉपिक बनाने के लिए, रूट Kafka डायरेक्टरी से नया कमांड प्रॉम्प्ट शुरू करें और निम्न कमांड चलाएँ:
.\bin\windows\kafka-topics.bat --create --topic MyFirstTopic --bootstrap-server localhost:9092यह “MyFirstTopic” नामक एक नया Kafka टॉपिक बनाएगा।
नोट: यह सुनिश्चित करने के लिए कि यह सही तरीके से बना है, कमांड चलाने पर “Create topic <name of topic>.” रिटर्न होगा।
Kafka टॉपिक में संदेश डालने के लिए प्रोड्यूसर शुरू करना होगा। ऐसा करने के लिए निम्न कमांड चलाएँ:
.\bin\windows\kafka-console-producer.bat --topic MyFirstTopic --bootstrap-server localhost:9092रूट Kafka डायरेक्टरी से एक और कमांड प्रॉम्प्ट खोलें और Kafka कंज़्यूमर शुरू करने के लिए निम्न कमांड चलाएँ:
.\bin\windows\kafka-console-consumer.bat --topic MyFirstTopic --from-beginning --bootstrap-server localhost:9092अब, जब भी प्रोड्यूसर में कोई संदेश प्रोड्यूस होता है, कंज़्यूमर उसे रियल टाइम में पढ़ लेता है।
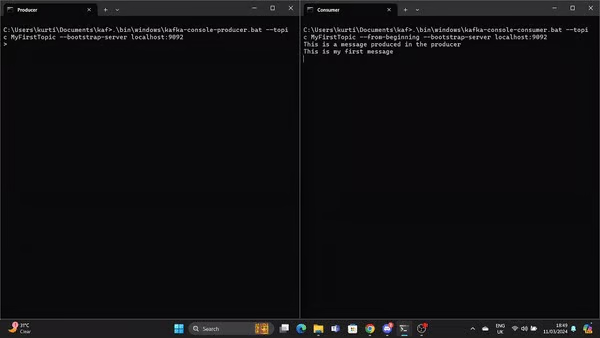
यह GIF दिखाता है कि प्रोड्यूसर द्वारा प्रोड्यूस किया गया संदेश रियल टाइम में Kafka कंज़्यूमर द्वारा पढ़ा जाता है।
आपने अभी अपना पहला Kafka टॉपिक बनाया और रियल टाइम में प्रोड्यूसर से कंज़्यूमर तक संदेश भेजा।
बेसिक मैसेज पासिंग से आगे बढ़कर Kafka कई उन्नत फीचर्स प्रदान करता है।
Apache Kafka का उपयोग करके, डेवलपर Kafka Streams के साथ फॉल्ट-टॉलरेंट स्ट्रीम-प्रोसेसिंग एप्लिकेशंस बना सकते हैं। यह सतत डेटा स्ट्रीम्स को संभालने, बदलने, और मूल्यांकन करने के लिए APIs और एक उच्च-स्तरीय डोमेन-विशिष्ट भाषा (DSL) प्रदान करता है।
कुछ प्रमुख फीचर्स:
Kafka Streams रिकॉर्ड स्ट्रीम्स की रियल-टाइम प्रोसेसिंग संभव बनाता है। यह आपको Kafka टॉपिक्स से डेटा लेने, उसे प्रोसेस और ट्रांसफॉर्म करने, और फिर प्रोसेस्ड जानकारी को वापस Kafka टॉपिक्स में भेजने में सक्षम बनाता है। स्ट्रीम प्रोसेसिंग निकट रियल-टाइम एनालिटिक्स, मॉनिटरिंग, और डेटा एन्हांसमेंट को सक्षम करती है। इसे व्यक्तिगत रिकॉर्ड्स या विंडोड एग्रीगेशंस पर लागू किया जा सकता है।
रिकॉर्ड्स से जुड़े टाइमस्टैम्प्स का उपयोग करके, आप Kafka Streams के इवेंट-टाइम प्रोसेसिंग सपोर्ट के साथ आउट-ऑफ-ऑर्डर रिकॉर्ड्स को संभाल सकते हैं। यह इवेंट-टाइम सिमेंटिक्स के साथ विंडोइंग ऑपरेशंस प्रदान करता है, जिससे विंडो जॉइनिंग, सेशनाइज़ेशन, और समय-आधारित एग्रीगेशंस संभव होती हैं।
Kafka Streams कई विंडोइंग ऑपरेशंस प्रदान करता है जो उपयोगकर्ताओं को सेशन विंडोज, टम्बलिंग विंडोज, स्लाइडिंग विंडोज, और फिक्स्ड टाइम विंडोज पर गणनाएँ करने में सक्षम बनाते हैं।
विंडोड प्रक्रियाओं के माध्यम से इवेंट-आधारित ट्रिगर्स, समय-संवेदी विश्लेषण, और समय-आधारित एग्रीगेशंस संभव होते हैं।
स्ट्रीम प्रोसेसिंग के दौरान, Kafka Streams उपयोगकर्ताओं को स्टेट को बनाए रखने और अपडेट करने में सक्षम बनाता है। स्टेट स्टोर्स के लिए बिल्ट-इन सपोर्ट प्रदान किया गया है। ध्यान दें कि स्टेट स्टोर एक की-वैल्यू स्टोर है जिसे प्रोसेसिंग टोपोलॉजी के भीतर अपडेट और क्वेरी किया जा सकता है।
जॉइन्स, एग्रीगेशंस, और एनोमली डिटेक्शन जैसी उन्नत स्ट्रीम प्रोसेसिंग फंक्शंस स्टेटफुल ऑपरेशंस से संभव होती हैं।
Kafka Streams एक्ज़ैक्टली-वान्स प्रोसेसिंग के लिए एंड-टू-एंड सिमेंटिक्स प्रदान करता है, जो यह सुनिश्चित करता है कि हर रिकॉर्ड को—भले ही फेलियर हो—ठीक एक बार ही हैंडल किया जाए। यह Kafka की बिल्ट-इन टिकाऊपन गारंटी और ट्रांजैक्शनल फीचर्स का उपयोग करके हासिल किया जाता है।
Kafka के लिए डिक्लेरेटिव, प्लगेबल डेटा इंटीग्रेशन फ्रेमवर्क को Kafka Connect कहा जाता है। यह Apache Kafka का एक ओपन-सोर्स, निःशुल्क घटक है, जो फ़ाइल सिस्टम्स, डेटाबेसेज़, सर्च इंडेक्सेस, और की-वैल्यू स्टोर्स के बीच आसान डेटा इंटीग्रेशन के लिए एक केंद्रीकृत डेटा हब के रूप में कार्य करता है।
Kafka डिस्ट्रीब्यूशन में डिफ़ॉल्ट रूप से Kafka Connect शामिल होता है। इसे इंस्टॉल करने के लिए, आपको बस एक वर्कर प्रोसेस शुरू करना होगा।
Kafka की रूट डायरेक्टरी से निम्न कमांड का उपयोग करके Kafka Connect वर्कर प्रोसेस लॉन्च करें:
.\bin\windows\connect-distributed.bat
.\config\connect-distributed.properties
यह Kafka Connect वर्कर को डिस्ट्रीब्यूटेड मोड में लॉन्च करेगा, जिससे क्लस्टर में अनेक वर्कर्स चलाने की उच्च उपलब्धता और स्केलेबिलिटी सक्षम होगी।
नोट: .\config\connect-distributed.properties फ़ाइल में Kafka ब्रोकर्स की जानकारी और Kafka Connect के अन्य कॉन्फ़िगरेशन गुण निर्दिष्ट होते हैं।
Kafka Connect बाहरी सिस्टम्स और Kafka टॉपिक्स के बीच डेटा स्थानांतरित करने के लिए कनेक्टर्स का उपयोग करता है। कनेक्टर्स को आपके विशिष्ट डेटा इंटीग्रेशन आवश्यकताओं के अनुरूप इंस्टॉल और कॉन्फ़िगर किया जा सकता है।
किसी कनेक्टर को इंस्टॉल करने के लिए, कनेक्टर JAR फ़ाइल को plugin.path डायरेक्टरी में डाउनलोड और जोड़ना पर्याप्त है, जिसका उल्लेख .\config\connect-distributed.properties फ़ाइल में है।
कनेक्टर के लिए एक कॉन्फ़िगरेशन फ़ाइल बनानी होगी, जिसमें कनेक्टर क्लास और अन्य विशेषताओं को निर्दिष्ट करना होगा। कनेक्टर्स का निर्माण और प्रबंधन करने के लिए Kafka Connect REST API और कमांड-लाइन टूल्स का उपयोग किया जा सकता है।
इसके बाद, अन्य सिस्टम्स से डेटा संयोजित करने के लिए आपको Kafka Connector कॉन्फ़िगर करना होगा। Kafka Connect विभिन्न सिस्टम्स—जैसे फ़ाइल सिस्टम्स, मैसेज क्यूज़, और डेटाबेसेज़—से डेटा इंटीग्रेट करने के लिए अनेक कनेक्टर्स प्रदान करता है। अपनी इंटीग्रेशन आवश्यकताओं के आधार पर कनेक्टर चुनें—कनेक्टर्स की सूची के लिए डॉक्यूमेंटेशन देखें।
Apache Kafka के कुछ सामान्य उपयोग मामलों पर नज़र डालें।
एक ऑनलाइन ई-कॉमर्स प्लेटफ़ॉर्म रियल टाइम में यूज़र गतिविधि को ट्रैक करने के लिए Kafka का उपयोग कर सकता है। प्रत्येक यूज़र क्रिया—जैसे उत्पाद देखना, कार्ट में आइटम जोड़ना, खरीदारी करना, समीक्षा देना, खोज करना, इत्यादि—को विशिष्ट Kafka टॉपिक्स पर इवेंट के रूप में प्रकाशित किया जा सकता है।
अन्य माइक्रोसर्विसेस इन इवेंट्स को स्टोर कर सकती हैं या रियल-टाइम फ्रॉड डिटेक्शन, रिपोर्टिंग, पर्सनलाइज़्ड ऑफ़र्स, और सिफारिशों के लिए उनका उपयोग कर सकती हैं।
उच्च थ्रूपुट, बिल्ट-इन पार्टिशनिंग, रेप्लिकेशन, फॉल्ट-टॉलरेंस, और स्केलिंग क्षमताओं के साथ, Kafka पारंपरिक मैसेज ब्रोकर्स का एक अच्छा विकल्प है।
माइक्रोसर्विस-आधारित राइड-हेलिंग ऐप विभिन्न सेवाओं के बीच संदेशों के आदान-प्रदान को सुगम बनाने के लिए इसका उपयोग कर सकता है।
उदाहरण के लिए, जब कोई राइडर बुकिंग करता है तो राइड-बुकिंग सेवा ड्राइवर-मैचिंग सेवा से Kafka के माध्यम से संचार कर सकती है। इसके बाद ड्राइवर-मैचिंग सेवा लगभग रियल टाइम में आस-पास एक ड्राइवर ढूँढ सकती है और संदेश के साथ उत्तर दे सकती है।
आमतौर पर, इसमें सर्वरों से फिजिकल लॉग फ़ाइलें प्राप्त करना और उन्हें प्रोसेसिंग के लिए किसी केंद्रीय स्थान—जैसे फ़ाइल सर्वर या डेटा लेक—में स्टोर करना शामिल है। Kafka डेटा को संदेशों की स्ट्रीम के रूप में एब्स्ट्रैक्ट करता है और फ़ाइल-विशिष्ट जानकारी को फ़िल्टर करता है। इससे कम विलंबता के साथ डेटा प्रोसेस करना संभव होता है और डिस्ट्रीब्यूटेड डेटा कंज़म्प्शन तथा विभिन्न डेटा स्रोतों को अधिक आसानी से समायोजित किया जा सकता है।
लॉग्स को Kafka पर प्रकाशित किए जाने के बाद, उन्हें लॉग विश्लेषण टूल या सिक्योरिटी इंफॉर्मेशन एंड इवेंट मैनेजमेंट (SIEM) सिस्टम द्वारा ट्रबलशूटिंग, सुरक्षा मॉनिटरिंग, और अनुपालन रिपोर्टिंग के लिए उपयोग किया जा सकता है।
कई Kafka उपयोगकर्ता डेटा को बहु-चरण प्रोसेसिंग पाइपलाइंस में प्रोसेस करते हैं। कच्चा इनपुट डेटा Kafka टॉपिक्स से लिया जाता है, एग्रीगेट, समृद्ध, या अन्यथा ट्रांसफॉर्म करके नए टॉपिक्स में भेजा जाता है ताकि आगे उपभोग या प्रोसेसिंग हो सके।
उदाहरण के लिए, कोई बैंक रियल-टाइम ट्रांजैक्शंस को प्रोसेस करने के लिए Kafka का उपयोग कर सकता है। ग्राहक द्वारा आरंभ की गई प्रत्येक ट्रांजैक्शन को एक इवेंट के रूप में Kafka टॉपिक पर पोस्ट किया जाता है। इसके बाद कोई एप्लिकेशन इन इवेंट्स को लेकर ट्रांजैक्शंस को सत्यापित और हैंडल कर सकता है, संदिग्ध को रोक सकता है, और तुरंत ग्राहक बैलेंस अपडेट कर सकता है।
कोई क्लाउड सेवा प्रदाता डिस्ट्रीब्यूटेड एप्लिकेशंस से सांख्यिकी एकत्र करने के लिए Kafka का उपयोग कर सकता है, ताकि ऑपरेशनल डेटा की रियल-टाइम केंद्रीकृत स्ट्रीम्स बनाई जा सकें। सैकड़ों सर्वरों से CPU और मेमोरी उपभोग, रिक्वेस्ट काउंट्स, एरर रेट्स आदि जैसे मेट्रिक्स Kafka को रिपोर्ट किए जा सकते हैं। इसके बाद मॉनिटरिंग एप्लिकेशंस इन मेट्रिक्स का उपयोग एनोमली डिटेक्शन, अलर्टिंग, और रियल-टाइम विज़ुअलाइज़ेशन के लिए कर सकते हैं।
Apache Kafka रियल-टाइम इवेंट स्ट्रीमिंग के लिए उद्योग मानक है, और Fortune 100 की 80% से अधिक कंपनियाँ इसका उपयोग करती हैं। Kafka 4.0 और KRaft मोड के साथ, क्लस्टर्स को डिप्लॉय और प्रबंधित करना पहले के संस्करणों की तुलना में सरल है।
इस लेख में, मैंने Kafka के महत्व, इसके मुख्य घटकों, चरण-दर-चरण सेटअप, Kafka Streams और Kafka Connect जैसे उन्नत फीचर्स, और वास्तविक दुनिया के अनुप्रयोगों को कवर किया। आगे सीखने के लिए देखें:
आज ही अपनी डेटा इंजीनियर यात्रा शुरू करें!
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें