

摘要
- Apache Kafka 是一个开源的分布式事件流平台,最初由 LinkedIn 开发,如今被超过 80% 的《财富》100 强公司采用
- 核心概念:broker(服务器)、topic(数据类别)、producer(写入方)和 consumer(读取方)
- Kafka 具备内置容错、横向扩展与消息回放能力,可每秒处理数百万条消息
- 高级功能包括用于实时处理的 Kafka Streams,以及与外部系统进行数据集成的 Kafka Connect
- 常见用例:活动追踪、微服务消息通信、日志聚合、流处理与指标采集
什么是 Apache Kafka?
Apache Kafka 是一个由 Jay Kreps、Jun Rao 和 Neha Narkhede 等人在 LinkedIn 开发的开源分布式事件流框架。该工具针对实时摄取与处理流数据进行了优化,因此可用于实现高性能数据管道、流式分析应用以及数据集成服务。
事件被存储后,事件流式平台会将其路由到相关服务。开发者无需依赖其他服务即可扩展和维护这样的系统。由于 Kafka 是一个集消息代理、事件存储与流处理框架于一体的套件,因此非常适合这类需求。
凭借高吞吐与高持久性,数百个数据源可同时提供持续不断的大规模数据流,Kafka 的消息代理系统可对其进行顺序且渐进式处理。
Kafka 与传统消息代理的对比
Kafka 与 RabbitMQ 等传统消息代理在多个基本方面存在差异:
| 特性 | Apache Kafka | 传统代理(如 RabbitMQ) |
|---|---|---|
| 消息保留 | 可配置(从数天到数年);消息在被消费后仍会保留 | 消息在消费者确认后即被删除 |
| 消费者模型 | 拉取式;消费者按自身节奏读取 | 推送式;代理主动投递给消费者 |
| 吞吐量 | 每秒数百万条消息 | 每秒数千到数万条 |
| 有序性 | 在单个分区内保证顺序 | 取决于实现 |
| 回放 | 消费者可在任意偏移量处重读历史消息 | 投递后不支持 |
| 主要用例 | 事件流、日志聚合、实时数据管道 | 任务队列、请求-响应模式 |
为什么选择 Kafka?
Apache Kafka 的主要优势包括:
高吞吐
Kafka 精心设计的架构,包括数据分区、批处理、零拷贝技术与仅追加日志,使其实现高吞吐、每秒处理数百万条消息,适用于高速与海量数据场景。其轻量级通信协议促进高效的客户端-代理交互,使实时数据流成为可能。
可扩展性
Apache Kafka 可通过将主题拆分为多个分区来跨服务器进行负载均衡。用户由此可在不同地理区域或可用区分布生产集群,并按需扩缩容。换言之,Kafka 可以轻松扩展,在大量分区上处理万亿级别的日消息量。
低延迟
Apache Kafka 通过解耦数据流,利用低延迟(最低约 2 毫秒)的服务器集群,在受限于网络的吞吐条件下高效投递消息。
持久性与可靠性
Apache Kafka 通过两种关键方式提升数据容错性与持久性:
- 在容错集群中分布式存储数据流,防止服务器故障带来影响
- 将消息写入磁盘,并提供集群内副本复制
高可用性
得益于基于集群的 broker,即便服务器宕机,Kafka 仍可继续运行。当某台服务器出现问题时,Kafka 会智能地将请求路由到其他 broker。
Kafka 的核心组件
Apache Kafka 使用户能够实时分析数据、按创建顺序存储记录,并对其进行发布与订阅。
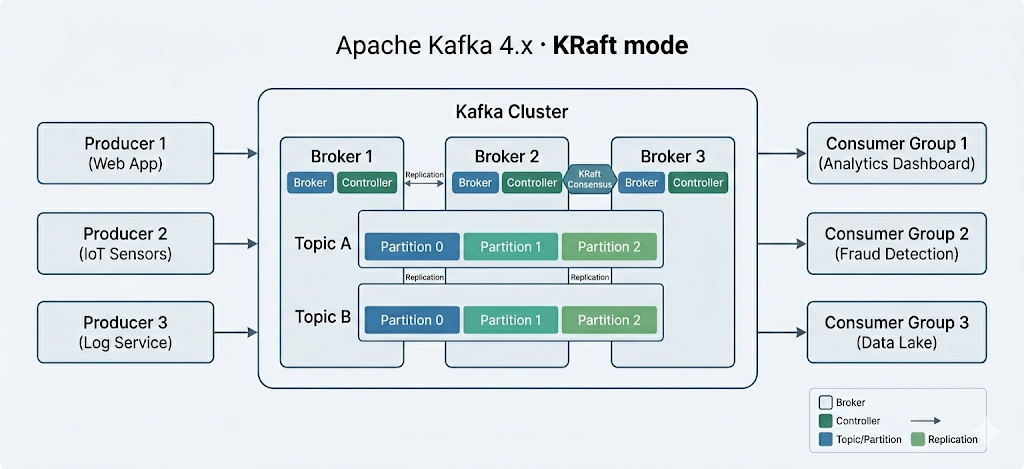
Apache Kafka 的核心组件
如上图所示,Apache Kafka 是一个可横向扩展的通用服务器集群,可从多个“生产者”系统与应用(如日志、监控、传感器与物联网应用)处理实时数据,并以极低延迟提供给多个“消费者”系统与应用(如实时分析)。
请注意,依赖实时数据处理与分析系统的应用都可视为消费者,例如基于位置的微营销或物流应用。
以下是理解 Kafka 核心组件时需要掌握的一些关键术语:
- Broker 是集群中的服务器,用于存储数据并为客户端提供服务。
- Topic 是发布记录的类别或数据源。请注意,Topic 分为压缩(compacted)与常规两类。存储在压缩 Topic 中的记录不受时间或空间限制;具有相同键的旧消息会被新消息更新,除非用户删除,Kafka 不会移除最新消息。相反,常规 Topic 中的记录可配置过期,从而删除过时数据,释放存储空间。
- Producer 是向 Kafka Topic 发布(写入)事件的客户端应用。
- Consumer 是从 Kafka Topic 读取并处理事件的应用。借助 Kafka Streams API,开发者可以编写从 Topic 检索数据并将结果返回给 Kafka 的 Java 程序。外部流处理系统(如 Apache Spark、Apache Apex、Apache Flink、Apache NiFi 与 Apache Storm)也可处理这些消息流。
- Kafka 使用名为 “Streams” 的客户端库来构建微服务与应用,数据以集群为输入与输出进行存储。
Kafka 快速上手
重要(2025 年更新):Apache Kafka 4.0(2025 年 3 月发布)完全移除了 ZooKeeper,转而采用 KRaft(Kafka Raft)模式。下文的安装步骤使用 ZooKeeper,仅适用于 Kafka 3.x。对于 Kafka 4.x,不再需要或支持 ZooKeeper。若您从零开始,建议使用基于 Docker 的 KRaft 模式以获得更简化的部署。
通常建议在 Apache Kafka 3.x 中配合 Zookeeper 启动,以获得最佳兼容性。此外,Kafka 在 Windows 上安装可能遇到多个问题,因为其并非为该系统原生设计。因此,建议在 Windows 上通过 WSL2 或 Docker 启动 Kafka。
不建议在 Windows 上直接使用 JVM 运行 Kafka,因为其不具备 Linux 特有的部分 POSIX 特性。如果不使用 WSL2 而尝试在 Windows 上运行 Kafka,最终很可能会遇到问题。
话虽如此,在 Windows 上安装 Apache Kafka 的第一步是安装 WSL2。
步骤 1:安装 WSL2
WSL2(Windows Subsystem for Linux 2)让您的 Windows 电脑无需虚拟机即可使用 Linux 环境。
大多数 Linux 命令都兼容 WSL2,从而使 Kafka 的安装流程更接近于 Mac 与 Linux 的说明。
提示:在安装 WSL2 前,请确保您运行的是 Windows 10 版本 2004 或更高(内部版本 19041 及以上)。按下 Windows 徽标键 + R,输入“winver”,然后单击“确定”查看 Windows 版本。
安装 Windows Subsystem for Linux(WSL)的最简单方式,是在管理员权限的 PowerShell 或 Windows 命令提示符中运行以下命令,然后重启计算机:
wsl --install请注意,系统会提示您为新安装的 Linux 发行版创建用户账户和密码。
如果遇到问题,请参考 Microsoft Docs 网站上的步骤。
步骤 2:安装 Java
如果您的机器尚未安装 Java,请下载最新版本。
步骤 3:安装 Apache Kafka
截至本次更新,Apache Kafka 的最新稳定版本为 4.2.0(2026 年 2 月发布)。Kafka 4.0(2025 年 3 月)以 KRaft 模式取代 ZooKeeper 进行元数据管理。要获取当前稳定版本,请查看下载页面。
在二进制下载中获取最新版本。
下载完成后,前往 Kafka 的下载目录,解压缩文件。注意,我们将新文件夹命名为“Kafka”。
步骤 4:启动 ZooKeeper
在 Apache Kafka 3.x 中,ZooKeeper 用于集群管理。因此,必须先于 Kafka 启动。无需单独安装 ZooKeeper,因为它已包含在 Kafka 中。
打开命令提示符,导航到 Kafka 根目录。然后运行以下命令来启动 ZooKeeper:
.\bin\windows\zookeeper-server-start.bat .\config\zookeeper.properties步骤 5:启动 Kafka 服务器
再打开一个命令提示符,在 Kafka 根目录运行以下命令以启动 Kafka:
.\bin\windows\kafka-server-start.bat .\config\server.properties步骤 6:创建 Topic
要创建 Topic,请从 Kafka 根目录启动新的命令提示符并运行以下命令:
.\bin\windows\kafka-topics.bat --create --topic MyFirstTopic --bootstrap-server localhost:9092这将创建一个名为“MyFirstTopic”的新 Kafka Topic。
注意:为确认创建成功,执行命令后将返回“Create topic <name of topic>.”
步骤 7:启动 Kafka Producer
要向 Kafka Topic 中放入消息,必须先启动 Producer。执行以下命令即可:
.\bin\windows\kafka-console-producer.bat --topic MyFirstTopic --bootstrap-server localhost:9092步骤 8:启动 Kafka Consumer
从 Kafka 根目录再打开一个命令提示符,运行以下命令以启动 Kafka Consumer:
.\bin\windows\kafka-console-consumer.bat --topic MyFirstTopic --from-beginning --bootstrap-server localhost:9092现在,当 Producer 产生一条消息时,Consumer 会实时读取到它。
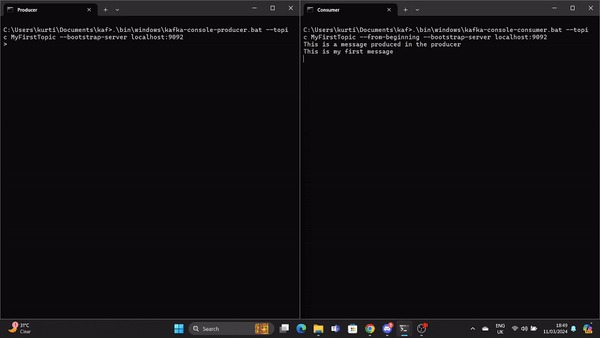
该 GIF 演示了 Producer 产生的消息被 Kafka Consumer 实时读取。
您已创建了第一个 Kafka Topic,并实现了从生产者到消费者的实时消息传递。
Kafka 的高级功能
除了基础的消息传递外,Kafka 还提供多种高级功能。
Kafka Streams
借助 Apache Kafka,开发者可以使用 Kafka Streams 构建具备容错性的流处理应用。它提供 API 与高级领域特定语言(DSL),用于处理、转换与评估持续的数据流。
一些关键特性包括:
流处理
Kafka Streams 支持对记录流进行实时处理。您可以从 Kafka Topic 摄取数据,对其进行处理和转换,然后将处理后的信息写回 Kafka Topic。流处理可实现近实时的分析、监控与数据富化,既可作用于单条记录,也可用于窗口聚合。
事件时间处理
利用记录所带的时间戳,Kafka Streams 支持事件时间处理,可应对乱序记录。它提供具备事件时间语义的窗口操作,支持窗口连接、会话化与基于时间的聚合。
基于时间的操作与窗口
Kafka Streams 提供多种窗口操作,使用户能够在会话窗口、翻转窗口、滑动窗口与固定时间窗口上执行计算。
通过窗口化操作,可以实现事件触发、时序敏感分析与基于时间的聚合。
有状态处理
在流处理过程中,Kafka Streams 允许保留并更新状态,并内置对状态存储的支持。注意,状态存储是一种可在处理拓扑中更新与查询的键值存储。
有状态操作使连接、聚合与异常检测等高级流处理功能成为可能。
精确一次处理
Kafka Streams 提供端到端的精确一次(exactly-once)处理语义,确保每条记录即使在发生故障时也仅被处理一次。这依赖于 Kafka 内置的持久性保证与事务特性。
Kafka Connect
Kafka 的声明式、可插拔数据集成框架称为 Kafka Connect。它是 Apache Kafka 的开源免费组件,充当集中式数据枢纽,便于在文件系统、数据库、搜索索引与键值存储之间进行数据集成。
Kafka 发行版默认包含 Kafka Connect。要安装它,只需启动一个 worker 进程。
在 Kafka 根目录使用以下命令启动 Kafka Connect worker 进程:
.\bin\windows\connect-distributed.bat
.\config\connect-distributed.properties这将以分布式模式启动 Kafka Connect worker,从而在集群中运行多个 worker,获得高可用性与可扩展性。
注意:.\config\connect-distributed.properties 文件指定了 Kafka broker 信息以及 Kafka Connect 的其他配置属性。
Kafka Connect 通过连接器(Connector)在外部系统与 Kafka Topic 之间传输数据。您可以按数据集成需求安装并配置连接器。
安装连接器只需下载并将其 JAR 文件添加到 plugin.path(定义于 .\config\connect-distributed.properties)目录中即可。
接着需要创建连接器的配置文件,指定连接器类与其他参数。您可以使用 Kafka Connect 的 REST API 与命令行工具来创建与管理连接器。
随后,为与其他系统整合数据,您需配置 Kafka Connector。Kafka Connect 为多种系统(如文件系统、消息队列与数据库)提供了丰富的连接器。请根据集成需求选择连接器——参见文档获取连接器列表。
Kafka 的真实应用场景
以下是 Apache Kafka 的几个常见用例。
活动追踪
电商平台可以使用 Kafka 实时追踪用户行为。每一次用户操作,例如查看商品、加入购物车、完成购买、留下评价、执行搜索等,都可作为事件发布到特定的 Kafka Topic。
其他微服务可以存储或利用这些事件,用于实时欺诈检测、报表、个性化优惠与推荐。
消息通信
凭借更高吞吐、内置分区、复制、容错与可扩展能力,Kafka 是传统消息代理的优选替代方案。
基于微服务的网约车应用可以用它来促进各服务之间的消息交换。
例如,当乘客发起叫车时,平台可通过 Kafka 与司机匹配服务通信;司机匹配服务随后几乎实时地找到附近司机并回复消息。
日志聚合
传统方式通常从服务器收集物理日志文件,并将其存储到集中位置(如文件服务器或数据湖)进行处理。Kafka 将数据抽象为消息流,并过滤掉文件特定信息,由此降低处理延迟,更轻松地适配分布式消费与多种数据源。
日志发布到 Kafka 后,可由日志分析工具或安全信息与事件管理(SIEM)系统用于故障排查、安全监控与合规报告。
流处理
许多 Kafka 用户会在多阶段处理管道中处理数据。从 Kafka Topic 获取原始输入数据,对其进行聚合、富化或其他转换,再写入新 Topic 供后续消费或处理。
例如,银行可用 Kafka 处理实时交易。客户发起的每笔交易都会作为事件发布到 Kafka Topic。随后,应用可摄取这些事件、校验并处理交易、拦截可疑交易,并即时更新客户余额。
指标
云服务提供商可以使用 Kafka 汇聚分布式应用的统计数据,生成实时且集中化的运营数据流。来自数百台服务器的指标,如 CPU 与内存使用、请求计数、错误率等,都可上报到 Kafka。监控应用随后利用这些指标进行异常检测、告警与实时可视化。
结语
Apache Kafka 是实时事件流的行业标准,被超过 80% 的《财富》100 强公司采用。借助 Kafka 4.0 与 KRaft 模式,集群的部署与管理较以往版本更为简化。
本文介绍了 Kafka 的重要性、核心组件、分步式搭建流程,以及 Kafka Streams 与 Kafka Connect 等高级功能与真实应用场景。继续学习,请查看:
- DataCamp 上的 Apache Kafka 入门 课程
- Kafka Streams 教程(实现实时数据处理)
- 如何在 2026 年成为数据工程师
- Python 数据工程师职业路径

微服务与事件驱动架构正在定义现代应用版图,基于批处理的时代已成过去。为满足速度与可用性的要求,开发者追求近乎实时的处理与完全解耦的应用架构。
解耦应用通常使用事件管理系统,来帮助不同服务之间的集成。事件存储的另一种用法是在基于事件溯源的架构中,所有应用逻辑都以事件来表达。这正是 Apache Kafka 登场的背景。
本质上,Kafka 是一个分布式事件存储与流处理框架,可用作消息代理、事件存储、队列管理系统等。您可以在另一篇指南中阅读我们对比的Kafka 与 Amazon SQS,并在教程中查看Kafka 分区的工作方式。
如果您想制定学习计划,请查阅这篇博客:如何学习 Apache Kafka。