आज की डेटा-प्रधान दुनिया में स्केलेबल, उच्च-प्रदर्शन और अत्यधिक उपलब्ध डेटाबेस की ज़रूरत पहले से कहीं अधिक है। Amazon DynamoDB, AWS (Amazon Web Services) द्वारा प्रदत्त, पूर्ण-प्रबंधित, सर्वरलेस, वाइड-कॉलम की-वैल्यू स्टोर इन मांगों को पूरा करने के लिए डिज़ाइन किया गया है। चाहे आप वेब एप्लिकेशन, मोबाइल ऐप या कोई ऐसा सिस्टम बना रहे हों जिसे लचीले और भरोसेमंद स्टोरेज की आवश्यकता हो, DynamoDB आपकी सभी ज़रूरतें पूरी करता है।
यह ट्यूटोरियल आपको Amazon DynamoDB की दुनिया से परिचित कराने और इसे Node.js एप्लिकेशंस में प्रभावी ढंग से उपयोग करना सिखाने के उद्देश्य से बनाया गया है। चाहे आप NoSQL डेटाबेस के साथ अभी शुरुआत कर रहे एक शुरुआती हों या अपने कौशल को बढ़ाने के इच्छुक एक अनुभवी डेवलपर, यह गाइड आपको मूलभूत बातों से परिचित कराएगा और शुरुआत करने के लिए व्यावहारिक उदाहरण देगा।
DynamoDB क्या है?
Amazon DynamoDB एक सर्वरलेस, की-वैल्यू और डॉक्यूमेंट डेटाबेस है जो सहज स्केलेबिलिटी और लो-लेटेंसी प्रदर्शन प्रदान करता है। पारंपरिक रिलेशनल डेटाबेस के विपरीत, DynamoDB में आपको हार्डवेयर प्रोविजन करने या इन्फ्रास्ट्रक्चर प्रबंधित करने की आवश्यकता नहीं होती, जिससे यह बदलते वर्कलोड के अनुसार डायनेमिक रूप से स्केल करने वाली एप्लिकेशंस के लिए आदर्श बन जाता है।
DynamoDB की प्रमुख विशेषताएं शामिल हैं:
स्केलेबिलिटी
DynamoDB प्रति सेकंड लाखों रिक्वेस्ट संभाल सकता है, जो इसे अलग-अलग स्तर के ट्रैफिक वाली एप्लिकेशंस के लिए उपयुक्त बनाता है।
उच्च उपलब्धता
एकाधिक अवेलेबिलिटी ज़ोन्स में अंतर्निहित प्रतिकृति के साथ उच्च उपलब्धता और डेटा की दृढ़ता के लिए डिज़ाइन किया गया।
प्रबंधित सेवा
AWS हार्डवेयर प्रोविजनिंग, पैचिंग और बैकअप सहित संचालन से जुड़ी जटिलताओं का ध्यान रखता है, ताकि आप अपने एप्लिकेशन के निर्माण पर ध्यान केंद्रित कर सकें।
लचीला डेटा मॉडल
DynamoDB की-वैल्यू और डॉक्यूमेंट दोनों डेटा मॉडल का समर्थन करता है, जिससे आप अपने डेटा की संरचना में लचीलापन रख सकते हैं।
सुरक्षा
AWS Identity and Access Management (IAM) एकीकरण आपको आइटम और एट्रिब्यूट स्तर पर अपने डेटाबेस संसाधनों के लिए सूक्ष्म-स्तरीय, सुरक्षित एक्सेस नियंत्रण सक्षम करता है।
लागत बचत
DynamoDB की सर्वरलेस आर्किटेक्चर और ऑटोमेटिक स्केलिंग क्षमताओं के साथ, आप केवल उपभोग किए गए संसाधनों के लिए भुगतान करके लागत का अनुकूलन कर सकते हैं। कोई अग्रिम हार्डवेयर लागत या दीर्घकालिक प्रतिबद्धता नहीं होती, जिससे यह स्टार्टअप और एंटरप्राइज़ दोनों के लिए किफायती विकल्प बन जाता है।
डेटा प्रकार
DynamoDB में समर्थित डेटा प्रकार:
- स्केलर प्रकार: इनमें स्ट्रिंग्स, नंबर्स, बाइनरी, बूलियन और null मान शामिल हैं।
- डॉक्यूमेंट प्रकार: DynamoDB नेस्टेड एट्रिब्यूट्स के साथ जटिल संरचनाओं को समायोजित करता है, जो JSON डेटा संभालने के लिए उपयुक्त है।
- सेट प्रकार: स्ट्रिंग सेट्स, नंबर सेट्स और बाइनरी सेट्स आपको संबंधित मानों के कलेक्शन को कुशलता से स्टोर करने में सक्षम बनाते हैं।
Node.js के साथ DynamoDB क्यों?
Node.js सर्वर-साइड एप्लिकेशंस, जैसे वेब सर्वर और API, बनाने के लिए एक लोकप्रिय रनटाइम वातावरण है। इसकी नॉन-ब्लॉकिंग, इवेंट-ड्रिवन आर्किटेक्चर, DynamoDB के asynchronous API के साथ अच्छी तरह मेल खाती है, जो इसे Node.js डेवलपर्स के लिए स्वाभाविक विकल्प बनाती है।
इस ट्यूटोरियल में, हम निम्नलिखित विषयों को कवर करेंगे:
1. DynamoDB में टेबल बनाना और स्कीमा परिभाषित करना।
2. AWS SDK for Node.js का उपयोग करके बुनियादी CRUD (Create, Read, Update, Delete) ऑपरेशंस करना।
3. ACID अनुपालन के साथ उन्नत क्वेरी करना।
इस ट्यूटोरियल के अंत तक, आपके पास Amazon DynamoDB की ठोस समझ होगी और आप अपने Node.js एप्लिकेशंस में इसकी शक्ति का उपयोग कर सकेंगे। तो चलिए शुरुआत करते हैं और इस बहुमुखी NoSQL डेटाबेस की संभावनाओं को अनलॉक करते हैं!
तैयारी
शुरू करने से पहले, आपको एक AWS खाता चाहिए होगा। हम यह सब AWS खाता के बिना भी कर सकते थे, लेकिन अधिक यथार्थवादी उदाहरण के लिए हम AWS में अपनी इन्फ्रास्ट्रक्चर बनाने हेतु terraform का उपयोग करेंगे। AWS सेवाओं के साथ स्थानीय रूप से Docker का उपयोग करके कैसे काम करें, इस पर अधिक जानकारी के लिए मेरे पास एक उदाहरण डेमो localstack github repository है, जिसे आप संदर्भ और प्रयोग के लिए देख सकते हैं।
यदि आपके पास पहले से नहीं है तो अब terraform इंस्टॉल करने का समय भी है।
इस ट्यूटोरियल के शेष भाग में यह माना गया है कि आपने AWS CLI अपने क्रेडेंशियल्स और कॉन्फिग फाइलों के साथ सेटअप कर लिया है और आपके पास terraform इंस्टॉल है।
शुरू करना
इस ट्यूटोरियल के लिए हम typescript और yarn का उपयोग करेंगे। हम शुरुआत में सरलता से ts-node का उपयोग करेंगे और फिर अगले ट्यूटोरियल में सर्वरलेस होंगे और इसे आगे बढ़ाते हुए AWS Lambda का उपयोग करेंगे।
अपने डेमो प्रोजेक्ट को सेटअप करने के लिए, एक नया फ़ोल्डर बनाएँ और फिर निम्नलिखित डिपेंडेंसीज़ और सेटअप जोड़ने के लिए यह कमांड चलाएँ:
yarn init
yarn add --dev typescript ts-node @types/node @types/ramda @types/uuid
yarn add @aws-sdk/client-dynamodb ramda uuid
npx tsc --init
mkdir src src/domain infra
touch ./src/index.ts ./src/client.ts ./infra/main.tf ./src/domain/student.ts
अब package.json में नीचे दिया गया scripts सेक्शन जोड़ें
  "scripts": {
    "dev": "ts-node src/index.ts"
  },
main.tf
provider "aws" {
  region = "eu-west-1"
}


resource "aws_dynamodb_table" "demo-table" {
  name = "demo-table"
  billing_mode = "PAY_PER_REQUEST"
  hash_key = "pk"
  range_key = "sk"


  attribute {
    name = "pk"
    type = "S"
  }


  attribute {
    name = "sk"
    type = "S"
  }
}
कमांड लाइन से infra डायरेक्टरी में cd करें और terraform init && terraform apply -auto-approve चलाएँ और फिर AWS कंसोल पर जाकर अपनी DynamoDB टेबल देखें:
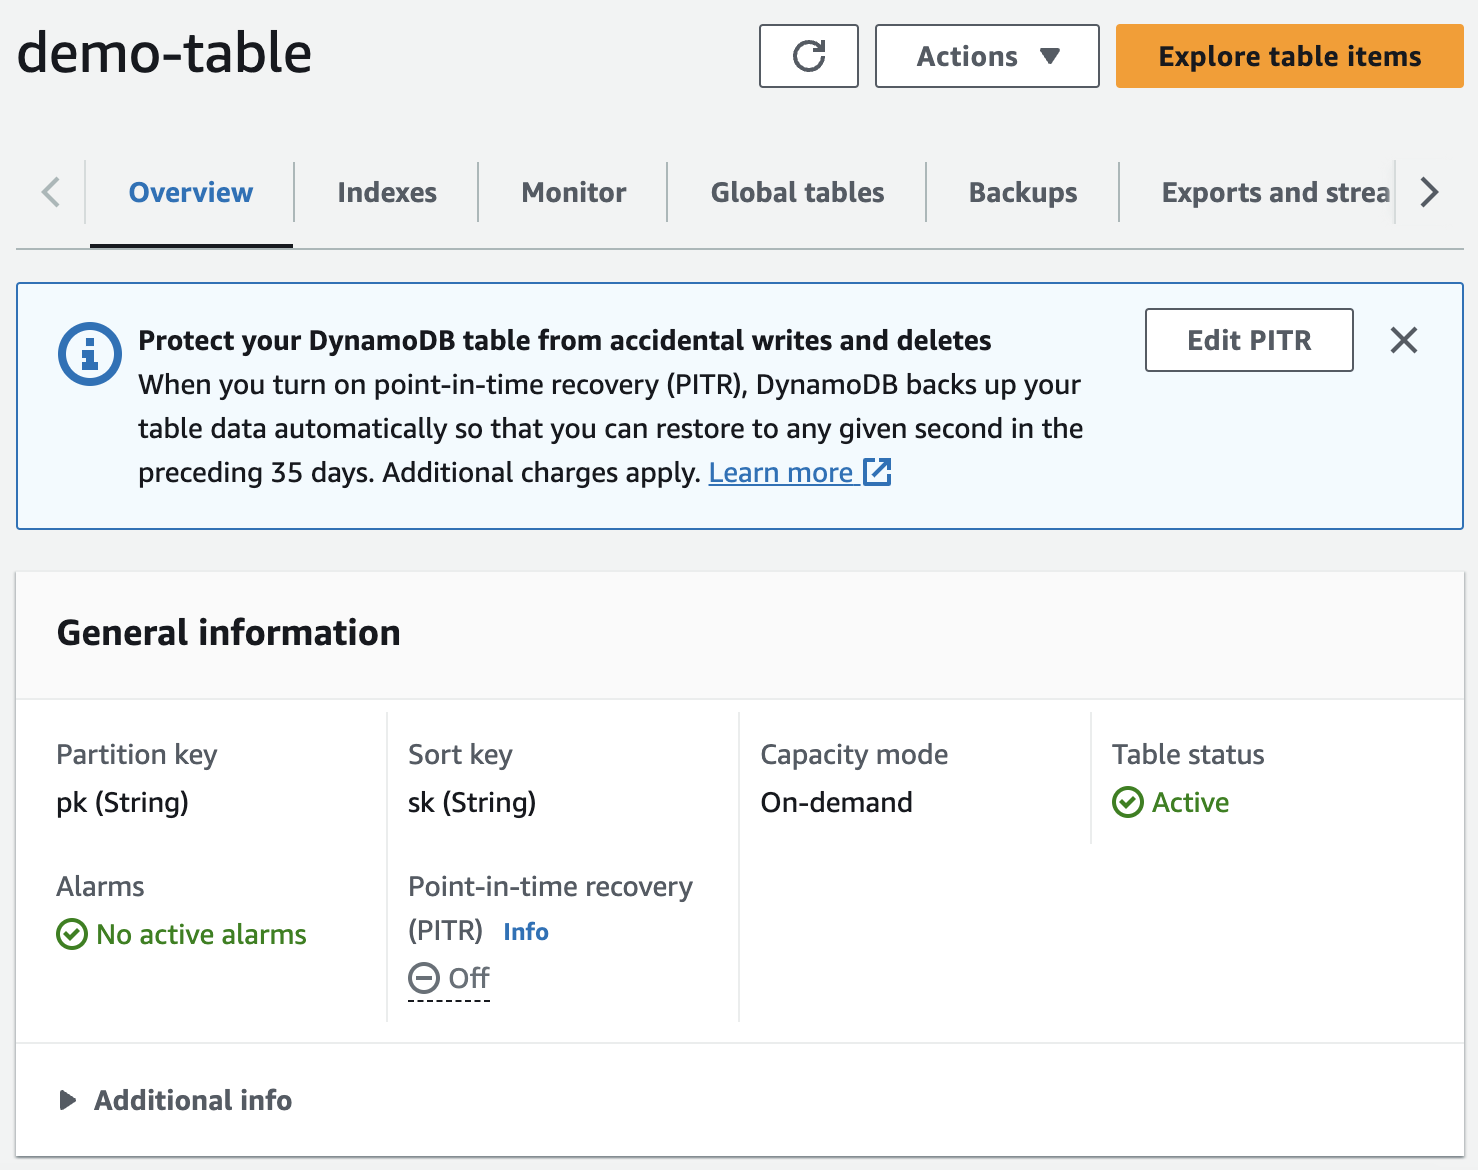
मैं DynamoDB के बिलिंग मोड्स, WCU, RCU को एक अलग लेख में कवर करूँगा
client.ts
import { DynamoDB } from "@aws-sdk/client-dynamodb";


export const TABLE_NAME = "demo-table";
export const REGION = "eu-west-1";
export const dynamoClient = new DynamoDB({ region: REGION });


export const STUDENT_PREFIX = "student#";
डेटा मॉडल
आगे बढ़ने से पहले, आइए एक डेटा मॉडल परिभाषित करें जिसका उपयोग हम इस ट्यूटोरियल के दायरे में कर सकें। संदर्भ बनाए रखने के लिए, मैंने DataCamp की मुख्य विशेषताओं के काफ़ी निकट किसी चीज़ का मॉडल चुन लिया है।
यह ट्यूटोरियल सभी एंटिटीज़ को कवर नहीं करेगा। मैं आने वाले लेखों में इस मॉडल का विस्तार करूँगा।
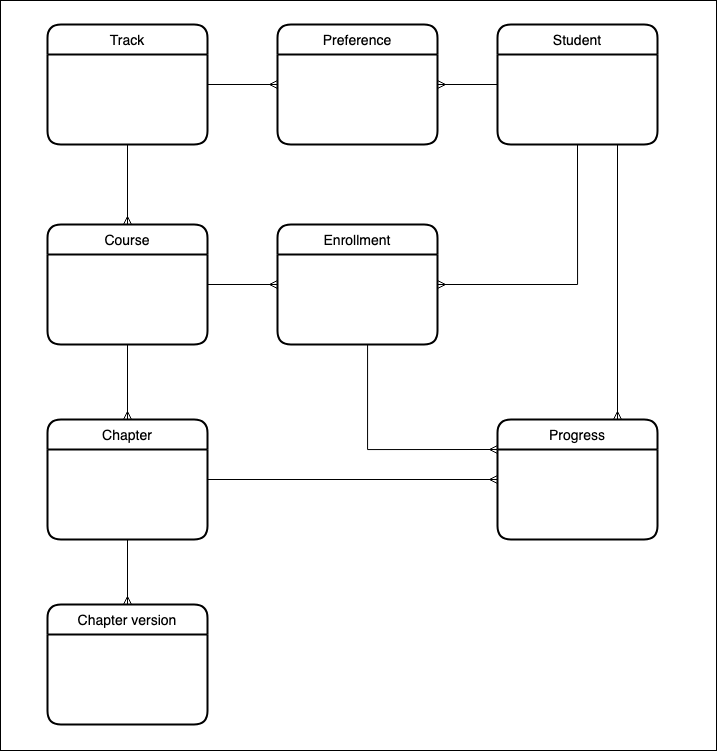
DynamoDB के साथ CRUD ऑपरेशंस
DynamoDB के साथ डेटा डिज़ाइन और मॉडल कैसे करें, इसकी पूरी समझ के लिए मेरा DynamoDB के साथ सिंगल टेबल डिज़ाइन पर ट्यूटोरियल देखें। इस ट्यूटोरियल में, मैं DynamoDB कैसे काम करता है, इस पर व्याख्या को सीमित रखने की कोशिश करूँगा। याद रखने वाली मुख्य बात यह है कि DynamoDB कुशल डेटा प्रबंधन के लिए पार्टिशन की और सॉर्ट की का उपयोग करता है।
पार्टिशन की
पार्टिशन की डेटा को कई स्टोरेज सर्वर्स में वितरित करने के लिए उपयोग की जाती है। यह महत्वपूर्ण है कि आप ऐसी पार्टिशन की चुनें जो आपका डेटा समान रूप से वितरित करे, ताकि "हॉट पार्टिशन" (असमान डेटा वितरण) से बचा जा सके, जो प्रदर्शन से जुड़ी समस्याओं का कारण बन सकता है।
डेटा को समान रूप से वितरित करने में सहायक पार्टिशन की के लिए सामान्य विकल्पों में उच्च-कार्डिनैलिटी एट्रिब्यूट्स शामिल हैं, जैसे:
- यूनिक IDs
- यूज़र IDs
- हैश वैल्यूज़
- भौगोलिक क्षेत्र
- समय-आधारित कीज़
- कॉम्पोज़िट कीज़
पार्टिशन की का चयन काफी हद तक एप्लिकेशन के एक्सेस पैटर्न और डेटा मॉडल पर निर्भर करेगा।
सॉर्ट की
सॉर्ट की वैकल्पिक होती है और आपको किसी पार्टिशन के भीतर डेटा व्यवस्थित करने देती है। पार्टिशन के भीतर डेटा की कुशल क्वेरी और सॉर्टिंग के लिए सॉर्ट की का उपयोग करें।
कॉम्पोज़िट की
कॉम्पोज़िट की में पार्टिशन और सॉर्ट की दोनों शामिल होती हैं। ये आपको रेंज, समय या अन्य एट्रिब्यूट्स के आधार पर फ़िल्टरिंग जैसे समृद्ध क्वेरी पैटर्न बनाने देती हैं। जब आपके डेटा एक्सेस पैटर्न को जटिल क्वेरीज़ की आवश्यकता हो, तो कॉम्पोज़िट की का उपयोग करें।
हॉट पार्टिशन
हॉट पार्टिशन को कम करने के लिए शार्डिंग (पार्टिशन की के लिए रैंडम प्रिफिक्स का उपयोग), समय-आधारित पार्टिशनिंग या लिखने के ऑपरेशंस को समान रूप से वितरित करने जैसी रणनीतियों पर विचार करें। क्षमता को डायनेमिक रूप से समायोजित करने के लिए मॉनिटर करें और AWS Auto Scaling का उपयोग करें।
student.ts
हम चीज़ों को सरल रखेंगे और छात्र ID को ही पार्टिशन और सॉर्ट की दोनों के रूप में उपयोग करेंगे। यह चुनाव अजीब लग सकता है, लेकिन हमें अपनी स्कीमा को लचीला रखना होगा और विभिन्न डेटा संबंधों और एक्सेस पैटर्न का समर्थन करने के लिए तैयार रखना होगा। मैं आने वाले DynamoDB लेखों में इस मॉडल का विस्तार करूँगा।
import { head, omit, pathOr } from "ramda";
import { STUDENT_PREFIX, TABLE_NAME, dynamoClient as client } from "../client";
import { v4 as uuidv4 } from "uuid";
import {
  addPrefix,
  attributeMapToValues,
  attributeValueToValue,
  removePrefix,
  valueToAttributeValue,
} from "../utils";


const entityType = "student";


export const dynamoRecordToStudent = (record: any) => {
  const { pk, ...data } = record;


  return omit(["sk"], {
    ...attributeMapToValues(data),
    id: removePrefix(attributeValueToValue<string>(pk), STUDENT_PREFIX),
  });
};


export const getStudentById = (id: string) =>
  client
    .getItem({
      TableName: TABLE_NAME,
      Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
  })
  .then(({ Item }) => (Item ? dynamoRecordToStudent(Item) : undefined));


export const saveStudent = async ({
  firstName,
  lastName,
  email,
}: {
  firstName: string;
  lastName: string;
  email: string;
}): Promise<string> => {
  const _id = uuidv4();
  const _email = email.toLocaleLowerCase();
  const xp = 0;


  await client.putItem({
    TableName: TABLE_NAME,
    Item: {
      pk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      firstName: valueToAttributeValue(firstName),
      lastName: valueToAttributeValue(lastName),
      email: valueToAttributeValue(_email),
      xp: valueToAttributeValue(xp),
      entityType: valueToAttributeValue(entityType),
    },
  });


  return _id;
};
utils.ts
AWS के नवीनतम DynamoDB SDK ने डेटाबेस में संग्रहीत आइटम्स के लिए टाइप सेफ्टी बढ़ा दी है, लेकिन ऐसा करने से इसके साथ काम करना थोड़ा मुश्किल हो गया है। इस कठिनाई को कम करने के लिए कुछ हेल्पर फ़ंक्शंस बनाते हैं। जब हम देखेंगे कि DynamoDB आंतरिक रूप से डेटा कैसे स्टोर करता है, तब स्पष्ट होगा कि हमें इनकी आवश्यकता क्यों है।
src फ़ोल्डर की रूट में utils.ts नाम से एक नई फ़ाइल बनाएँ।
import { AttributeValue } from "@aws-sdk/client-dynamodb";


export const valueToAttributeValue = <T>(value: T): AttributeValue => {
  switch (typeof value) {
    case "string":
      return { S: value };
    case "number":
      return { N: `${value}` };
    case "boolean":
      return { BOOL: value };
    case "object":
      if (Array.isArray(value)) {
        return { L: value.map((item) => valueToAttributeValue(item)) };
      }
      return {
        M: Object.entries(value as any).reduce(
          (acc, [key, item]) => ({
            ...acc,
            [key]: valueToAttributeValue(item),
          }),
          {}
        ),
      };
    default:
      throw new Error(`Unknown type ${typeof value}`);
  }
};


export const attributeValueToValue = <T>(value: AttributeValue): T => {
  switch (true) {
    case !!value.S:
      return value.S as T;
    case !!value.N:
      return Number(value.N) as T;
    case !!value.BOOL:
      return value.BOOL as T;
    case !!value.L:
      return value.L?.map((item) =>
        attributeValueToValue(item)
      ) as unknown as T;
    case !!value.M:
      return Object.entries(value.M || []).reduce(
        (acc, [key, item]) => ({ ...acc, [key]: attributeValueToValue(item) }),
        {}
      ) as unknown as T;
    default:
      throw new Error(`Unknown type ${JSON.stringify(value)}`);
  }
};


export const attributeMapToValues = (
  items: Record<string, AttributeValue>
): unknown[] =>
  Object.keys(items).reduce(
    (acc, key) => ({
      ...acc,
      [key]: attributeValueToValue(items[key]),
    }),
    []
  );


export const removePrefix = (id: string, prefix: string): string =>
  id.replace(prefix, "");


export const addPrefix = (id: string, prefix: string): string =>
  `${prefix}${removePrefix(id, prefix)}`;
नए छात्र का निर्माण
आखिरकार अब हम DynamoDB को CRUD ऑपरेशन API कॉल्स भेजना शुरू करने के लिए तैयार हैं!
index.ts फ़ाइल खोलें और नीचे दिया गया कोड पेस्ट करें, फिर cmd लाइन से yarn dev चलाएँ।
import { getStudentById, saveStudent } from "./domain/student";


Promise.resolve()
  .then(async () => {
    const id = await saveStudent({
      firstName: "John",
      lastName: "Smith",
      email: "john@datacamp.com",
    });


    const john = await getStudentById(id);


    console.log(john);
  })
  .catch((err) => {
    console.error(err);
    process.exit(1);
  })
  .then(() => {
    console.log("done");
    process.exit(0);
  });
आपको कुछ इस तरह का आउटपुट दिखना चाहिए:
{
  "entityType": "student",
  "id": "dd4c2ee4-9422-4957-ae6f-f9fff748e5ab",
  "firstName": "John",
  "lastName": "Smith",
  "email": "john@datacamp.com",
  "xp": 0
}
अब CLI का उपयोग करके DynamoDB को स्कैन करें, यह कमांड चलाएँ:
aws dynamodb scan --table-name demo-table --no-cli-pager
आप आउटपुट से देख सकते हैं कि DynamoDB आंतरिक रूप से डेटा को कैसे स्टोर और टाइप करता है, जहाँ N नंबर प्रकार और S स्ट्रिंग प्रकार को संदर्भित करता है, और इससे utils.ts में दिए गए कोड के बारे में आपके मन में उठे प्रश्न स्पष्ट होने चाहिए।
{
  "Items": [
    {
      "entityType": {
        "S": "student"
      },
      "lastName": {
        "S": "Smith"
      },
      "email": {
        "S": "john@datacamp.com"
      },
      "xp": {
        "N": "0"
      },
      "sk": {
        "S": "student#dd4c2ee4-9422-4957-ae6f-f9fff748e5ab"
      },
      "pk": {
        "S": "student#dd4c2ee4-9422-4957-ae6f-f9fff748e5ab"
      },
      "firstName": {
        "S": "John"
      }
    }
  ],
  "Count": 1,
  "ScannedCount": 1,
  "ConsumedCapacity": null
}
ईमेल पते से छात्र प्राप्त करना
यदि हमारे पास रिकॉर्ड खोजने के लिए केवल छात्र का ईमेल पता ही हो तो? हम एक ग्लोबल सेकेंडरी इंडेक्स जोड़कर इस एक्सेस पैटर्न का समर्थन कर सकते हैं।
सबसे पहले, हमें अपनी मूल टेबल को नष्ट करना होगा (भविष्य की terraform परिवर्तनों के लिए हम एक ट्रंकेट टेबल फ़ंक्शन जोड़कर इस चरण से बचेंगे):
terraform destroy
इसके बाद, अपने demo-table में नीचे दिया गया GSI जोड़कर terraform अपडेट करें:
attribute {
  name = "gsi1_pk"
  type = "S"
}


attribute {
  name = "gsi1_sk"
  type = "S"
}


global_secondary_index {
  name = "gsi1"
  hash_key = "gsi1_pk"
  range_key = "gsi1_sk"
  projection_type = "ALL"
}
इस परिवर्तन को लागू करें:
terraform apply -auto-approve
अब हमें छात्र को सेव करने के तरीके में थोड़ा संशोधन करना होगा:
export const saveStudent = async ({
  firstName,
  lastName,
  email,
}: {
  firstName: string;
  lastName: string;
  email: string;
}): Promise<string> => {
  const _id = uuidv4();
  const _email = email.toLocaleLowerCase();
  const xp = 0;


  await client.putItem({
    TableName: TABLE_NAME,
    Item: {
      pk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      gsi1_pk: valueToAttributeValue(_email),
      gsi1_sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      firstName: valueToAttributeValue(firstName),
      lastName: valueToAttributeValue(lastName),
      xp: valueToAttributeValue(xp),
      entityType: valueToAttributeValue(entityType),
    },
  });


  return _id;
};
ध्यान दें कि अब हम ईमेल को स्पष्ट रूप से स्टोर नहीं कर रहे, बल्कि इसे अपने GSI PK मान के रूप में उपयोग कर रहे हैं।
हमें DynamoDB छात्र डेटा को ट्रांसफॉर्म करने के तरीके में थोड़ा बदलाव करना होगा:
export const dynamoRecordToStudent = (record: any) => {
  const { pk, gsi1_pk, ...data } = record;


  return omit(["sk", "gsi1_sk"], {
    ...attributeMapToValues(data),
    id: removePrefix(attributeValueToValue<string>(pk), STUDENT_PREFIX),
    email: attributeValueToValue<string>(gsi1_pk),
  });
};
अंत में, हम अपने नए बनाए गए GSI gsi1 का उपयोग करके ईमेल पते से छात्र रिकॉर्ड प्राप्त करने के लिए क्वेरी कर सकते हैं:
export const getStudentByEmail = (email: string) =>
  client
    .query({
      TableName: TABLE_NAME,
      IndexName: "gsi1",
      KeyConditionExpression: "#gsi1_pk = :gsi1_pk",
      ExpressionAttributeNames: {
        "#gsi1_pk": "gsi1_pk",
      },
      ExpressionAttributeValues: {
        ":gsi1_pk": {
          S: email.toLocaleLowerCase(),
        },
      },
    })
    .then((res) => head(pathOr([], ["Items"], res).map(dynamoRecordToStudent)));
छात्र अपडेट करना
किसी छात्र को अपडेट करने के लिए हमें update मेथड का उपयोग करना होगा और जिस आइटम को अपडेट करना है उसे विशिष्ट रूप से पहचानने के लिए पार्टिशन और सॉर्ट की दोनों प्रदान करनी होंगी।
export const updateStudent = async ({
  id,
  firstName,
  lastName,
  email,
}: {
  id: string;
  firstName?: string;
  lastName?: string;
  email?: string;
}) => {
  const updateExpressionParts = [];
  const ExpressionAttributeValues: Record<string, any> = {};


  if (firstName !== undefined) {
    updateExpressionParts.push("#firstName = :firstName");
    ExpressionAttributeValues[":firstName"] = valueToAttributeValue(firstName);
  }


  if (lastName !== undefined) {
    updateExpressionParts.push("#lastName = :lastName");
    ExpressionAttributeValues[":lastName"] = valueToAttributeValue(lastName);
  }


  if (email !== undefined) {
    updateExpressionParts.push("#gsi1_pk = :gsi1_pk");
    ExpressionAttributeValues[":gsi1_pk"] = valueToAttributeValue(email);
  }


  const UpdateExpression = `SET ${updateExpressionParts.join(", ")}`;


  const ExpressionAttributeNames = {
    ...(firstName && { "#firstName": "firstName" }),
    ...(lastName && { "#lastName": "lastName" }),
    ...(email && { "#gsi1_pk": "gsi1_pk" }),
  };


  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression,
    ExpressionAttributeNames,
    ExpressionAttributeValues,
  });
};
डेटा हटाना
सबसे पहले यह बात कि DynamoDB में किसी टेबल को ट्रंकेट करना नैटिव रूप से समर्थित नहीं है, सिवाय पूरी टेबल हटाने और फिर से बनाने के (जैसा कि हमें नया GSI जोड़ने के लिए पहले करना पड़ा)। मैं client.ts में एक ट्रंकेट मेथड जोड़ने जा रहा हूँ, लेकिन मैं इस बात पर ज़ोर देना चाहता हूँ कि यह केवल परीक्षण उद्देश्यों के लिए है और प्रोडक्शन में उपयोग नहीं किया जाना चाहिए। कारण यह है कि क्या हटाना है यह जानने के लिए हमें पूरी टेबल स्कैन करनी पड़ती है, और DynamoDB में हर ऑपरेशन पर लागत आती है, इसलिए यदि आपकी टेबल में दस लाख आइटम हैं, तो आपके लिए उस टेबल को हटाकर फिर से शुरू करना सस्ता होगा (किसी न किसी डेटा माइग्रेशन प्रक्रिया के साथ ताकि आप कोई प्रोडक्शन डेटा न खोएँ)। यहाँ हमारा ट्रंकेट फ़ंक्शन है:
type AttributeMap = Record<string, AttributeValue>;


const getItemKeyAndValue = (item: AttributeMap, key?: string) =>
  key ? { [`${key}`]: item[`${key}`] } : {};


export const truncateTable = async (
  client: DynamoDB,
  TableName: string,
  hash: string,
  range?: string
): Promise<void> => {
  const { Items } = await client.scan({ TableName });
  if (!Items) {
    return;
  }
  const keys = Items.map((item: AttributeMap) => ({
    ...getItemKeyAndValue(item, hash),
    ...getItemKeyAndValue(item, range),
  }));
  if (!keys.length) {
    return;
  }
  await Promise.all(keys?.map((Key) => client.deleteItem({ TableName, Key })));
};
demo-table को ट्रंकेट करने के लिए:
await truncateTable(dynamoClient, TABLE_NAME, "pk", "sk");
किसी विशिष्ट छात्र को हटाने के लिए हम वास्तव में SDK के deleteItem मेथड का उपयोग नहीं करना चाहेंगे। NoSQL डेटाबेस में रेफ़रेंशियल इंटीग्रिटी की अवधारणा नहीं होती, और यदि हमारे डेटाबेस में कोई अन्य आइटम किसी ऐसे छात्र को संदर्भित कर रहा हो जो अब मौजूद नहीं है, तो यह समस्या होगी, और DynamoDB बिना किसी सुरक्षा जाल के हमारे बताए किसी भी आइटम को खुशी-खुशी डिलीट कर देगा, जबकि रिलेशनल डेटाबेस ऐसा करने पर विदेशी कुंजी संदर्भों की जाँच कर त्रुटि देता।
सावधानी बरतने के लिए हम एक सॉफ़्ट डिलीट लागू करेंगे और अपनी दो रीड फ़ंक्शंस में थोड़ा संशोधन करेंगे।
export const deleteStudent = async (id: string) => {
  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression: "SET #deleted = :deleted",
    ExpressionAttributeNames: {
      "#deleted": "deleted",
    },
    ExpressionAttributeValues: {
      ":deleted": valueToAttributeValue(true),
    },
  });
};
getStudentByEmail के लिए क्वेरी अब डिलीट किए गए रिकॉर्ड्स को फ़िल्टर कर देगी। यह नोट करना महत्वपूर्ण है कि यह "फ़िल्टरिंग" क्लाइंट साइड पर हो रही है, डेटाबेस पर नहीं; यानी यह क्वेरी डिलीट किए गए रिकॉर्ड्स को प्राप्त करने की वही लागत वहन करेगी।
{
  TableName: TABLE_NAME,
  IndexName: "gsi1",
  KeyConditionExpression: "#gsi1_pk = :gsi1_pk",
  ExpressionAttributeNames: {
    "#gsi1_pk": "gsi1_pk",
  },
  ExpressionAttributeValues: {
    ":gsi1_pk": {
      S: email.toLocaleLowerCase(),
    },
    ":notDeleted": {
      BOOL: false,
    },
  },
  FilterExpression:
    "attribute_not_exists(deleted) OR deleted = :notDeleted",
 }
getStudentById फ़ंक्शन getItem का उपयोग करता है, इसलिए हमारे पास फ़िल्टर एक्सप्रेशन लगाने का विकल्प नहीं है, इसके बजाय हम लॉजिक को स्पष्ट रूप से लिखेंगे:
export const getStudentById = (id: string): Promise<Student | null> =>
  client
    .getItem({
      TableName: TABLE_NAME,
      Key: {
        pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
        sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      },
    })
    .then(({ Item }) => {
      if (!Item) {
        return null;
      }
      const _item = dynamoRecordToStudent(Item);
      return _item.deleted ? null : _item;
    });
ACID अनुपालन के साथ एटॉमिक अपडेट्स
DataCamp प्रत्येक छात्र के लिए XP डेटा एकत्र करता है, जो प्रेरणा, उपलब्धि की भावना, कुल प्रगति को ट्रैक करने का आसान तरीका और छात्रों के लिए अपने साथियों के मुकाबले खुद को मापने का माध्यम प्रदान करता है। रिलेशनल डेटाबेस में हमारे पास डेटा में हेरफेर और एग्रीगेट करने के लिए कई उपकरण होते हैं, लेकिन NoSQL डेटाबेस के मामले में ऐसा नहीं है। हालांकि कुछ NoSQL डेटाबेस, जैसे MongoDB, एग्रीगेशन फ्रेमवर्क प्रदान करते हैं, लेकिन जब डेटाबेस बड़े पैमाने पर पहुँचता है तो ये उपकरण अक्सर विफल हो जाते हैं; और NoSQL चुनने का कारण अक्सर यही होता है कि हमें बड़े पैमाने पर डेटा और ट्रैफिक का समर्थन करना होता है।
DynamoDB में, एटॉमिक अपडेट्स का अर्थ है कि किसी आइटम के एकल एट्रिब्यूट पर ऐसे अपडेट ऑपरेशन करना जो Atomicity, Consistency, Isolation, और Durability (ACID गुण) सुनिश्चित करें। एटॉमिक अपडेट्स वे ऑपरेशन हैं जो किसी विशिष्ट एट्रिब्यूट के मान को इस तरह संशोधित करते हैं कि समवर्ती अपडेट्स की उपस्थिति में भी ऑपरेशन की सफलता की गारंटी हो।
इस तकनीक का उपयोग करके जब कोई उपयोगकर्ता कोई लर्निंग लक्ष्य पूरा करता है, तो हम आसानी से XP जोड़ सकते हैं।
export const updateStudentXp = async ({
  id,
  xp,
}: {
  id: string;
  xp: number;
}) => {
  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression: "set xp = xp + :inc",
    ExpressionAttributeValues: {
      ":inc": valueToAttributeValue(xp),
    },
  });
};
यदि यह कोड परिचित लग रहा है तो इसका कारण यह है कि हमने deleteStudent फ़ंक्शन के लिए पहले ही यह पैटर्न उपयोग किया है!
निष्कर्ष
इस ट्यूटोरियल में, हमने AWS द्वारा प्रदत्त सर्वरलेस, अत्यधिक स्केलेबल डेटाबेस Amazon DynamoDB के मूलभूत सिद्धांतों का अन्वेषण किया। DynamoDB की प्रमुख विशेषताएँ—सहज स्केलेबिलिटी, उच्च उपलब्धता और लचीला डेटा मॉडलिंग—इसे आधुनिक एप्लिकेशंस के लिए उत्कृष्ट विकल्प बनाती हैं।
हमने टेबल बनाना, Node.js का उपयोग करके CRUD ऑपरेशंस करना जैसे आवश्यक विषय कवर किए, और डेटा स्थिरता बनाए रखने हेतु एटॉमिक अपडेट्स के महत्व पर चर्चा की। ट्यूटोरियल के दौरान, हमने एक डेटा मॉडल विकसित किया और DynamoDB के साथ इंटरैक्ट करने के लिए फ़ंक्शंस लागू किए।
जैसे-जैसे आप DynamoDB में आगे बढ़ें, सिंगल टेबल डिज़ाइन, प्रदर्शन अनुकूलन, और रीयल-टाइम डेटा प्रोसेसिंग के लिए DynamoDB Streams जैसे उन्नत विषयों में गहराई से जाने पर विचार करें। DynamoDB की बहुमुखी प्रतिभा और स्केलेबिलिटी आपको AWS इकोसिस्टम के भीतर उच्च-प्रदर्शन, सर्वरलेस एप्लिकेशंस बनाने में सक्षम बनाती है।
आप इस ट्यूटोरियल का पूरा सोर्स कोड Github पर पा सकते हैं। शुभ कोडिंग!
अतिरिक्त शिक्षण सामग्री
- DataCamp ट्यूटोरियल: DynamoDB के साथ सिंगल टेबल डिज़ाइन
- DataCamp कोर्स: NoSQL अवधारणाएँ
- AWS re:Invent: DynamoDB के लिए उन्नत डिज़ाइन पैटर्न
- Rick Houlihan: DynamoDB सिंगल टेबल डिज़ाइन के मूल सिद्धांत
- Alex DeBrie: The DynamoDB Book