En un mundo cada vez más basado en datos, la necesidad de bases de datos escalables, de alto rendimiento y alta disponibilidad es mayor que nunca. Amazon DynamoDB, un almacén de clave-valor y documentos de columnas anchas, totalmente gestionado y sin servidor, ofrecido por AWS (Amazon Web Services), está diseñado para cubrir estas demandas. Ya sea que estés creando una aplicación web, una app móvil o cualquier sistema que requiera almacenamiento flexible y fiable, DynamoDB te lo pone fácil.
Este tutorial pretende introducirte en el mundo de Amazon DynamoDB y mostrarte cómo usarlo de forma eficaz en aplicaciones Node.js. Tanto si empiezas desde cero con bases de datos NoSQL como si eres un desarrollador con experiencia que quiere ampliar sus competencias, esta guía te llevará por lo esencial y te dará ejemplos prácticos para que puedas ponerte en marcha.
¿Qué es DynamoDB?
Amazon DynamoDB es una base de datos sin servidor de clave-valor y documentos que ofrece escalabilidad transparente y latencias muy bajas. A diferencia de las bases de datos relacionales tradicionales, DynamoDB no requiere aprovisionar hardware ni gestionar infraestructura, lo que la convierte en una opción ideal para aplicaciones que necesitan escalar dinámica y automáticamente según cambie la carga de trabajo.
Características clave de DynamoDB:
Escalabilidad
DynamoDB puede manejar millones de solicitudes por segundo, por lo que es adecuada para aplicaciones con tráfico variable.
Alta disponibilidad
Diseñada para alta disponibilidad y durabilidad de los datos, con replicación integrada entre múltiples zonas de disponibilidad.
Servicio gestionado
AWS se encarga de la operativa, incluido el aprovisionamiento de hardware, los parches y las copias de seguridad, para que tú te centres en construir tu aplicación.
Modelo de datos flexible
DynamoDB admite modelos de datos de clave-valor y de documentos, dándote flexibilidad a la hora de estructurar la información.
Seguridad
La integración con AWS Identity and Access Management (IAM) permite un control de acceso seguro y detallado a los recursos de tu base de datos a nivel de elemento y atributo.
Ahorro de costes
La arquitectura sin servidor de DynamoDB, junto con su escalado automático, te permite optimizar costes pagando solo por los recursos que consumes. No hay costes iniciales de hardware ni compromisos a largo plazo, lo que la hace atractiva tanto para startups como para grandes empresas.
Tipos de datos
Tipos de datos admitidos en DynamoDB:
- Tipos escalares: incluyen cadenas, números, binarios, booleanos y valores nulos.
- Tipos documento: DynamoDB admite estructuras complejas con atributos anidados, ideal para trabajar con datos JSON.
- Tipos conjunto: conjuntos de cadenas, de números y de binarios para almacenar colecciones de valores relacionados de forma eficiente.
¿Por qué usar DynamoDB con Node.js?
Node.js es un entorno de ejecución muy popular para crear aplicaciones del lado del servidor, incluidos servidores web y APIs. Su arquitectura no bloqueante y dirigida por eventos encaja muy bien con la API asíncrona de DynamoDB, lo que la convierte en una opción natural para desarrolladores de Node.js.
En este tutorial, cubriremos los siguientes temas:
1. Creación de tablas y definición de un esquema en DynamoDB.
2. Operaciones básicas CRUD (crear, leer, actualizar y eliminar) usando el AWS SDK para Node.js.
3. Consultas avanzadas con cumplimiento ACID.
Al final del tutorial, tendrás una base sólida de Amazon DynamoDB y sabrás cómo aprovechar su potencial en tus aplicaciones Node.js. ¡Vamos a ello y saquemos partido a esta versátil base de datos NoSQL!
Preparación
Antes de empezar, vas a necesitar una cuenta de AWS. Podríamos hacerlo todo sin una cuenta de AWS, pero para un ejemplo más realista, vamos a usar terraform para crear nuestra infraestructura en AWS. Si quieres saber cómo trabajar con servicios de AWS en local usando Docker, tengo un ejemplo de demo en localstack y un repositorio de GitHub de referencia para que pruebes.
Ahora también es buen momento para instalar terraform si aún no lo tienes.
El resto del tutorial asume que ya has configurado la AWS CLI con tus credenciales y archivos de configuración, y que tienes terraform instalado.
Primeros pasos
Para este tutorial vamos a usar TypeScript y yarn. Empezaremos de forma sencilla con ts-node y, en el siguiente tutorial, pasaremos a un enfoque serverless y ampliaremos esto usando AWS Lambda.
Para preparar nuestro proyecto de demo, crea una carpeta nueva y añade las siguientes dependencias y configuración ejecutando:
yarn init
yarn add --dev typescript ts-node @types/node @types/ramda @types/uuid
yarn add @aws-sdk/client-dynamodb ramda uuid
npx tsc --init
mkdir src src/domain infra
touch ./src/index.ts ./src/client.ts ./infra/main.tf ./src/domain/student.ts
A continuación, añade esta sección de scripts a package.json
  "scripts": {
    "dev": "ts-node src/index.ts"
  },
main.tf
provider "aws" {
  region = "eu-west-1"
}


resource "aws_dynamodb_table" "demo-table" {
  name = "demo-table"
  billing_mode = "PAY_PER_REQUEST"
  hash_key = "pk"
  range_key = "sk"


  attribute {
    name = "pk"
    type = "S"
  }


  attribute {
    name = "sk"
    type = "S"
  }
}
Desde la línea de comandos, entra en el directorio infra y ejecuta terraform init && terraform apply -auto-approve y luego ve a la consola de AWS para ver tu tabla de DynamoDB:
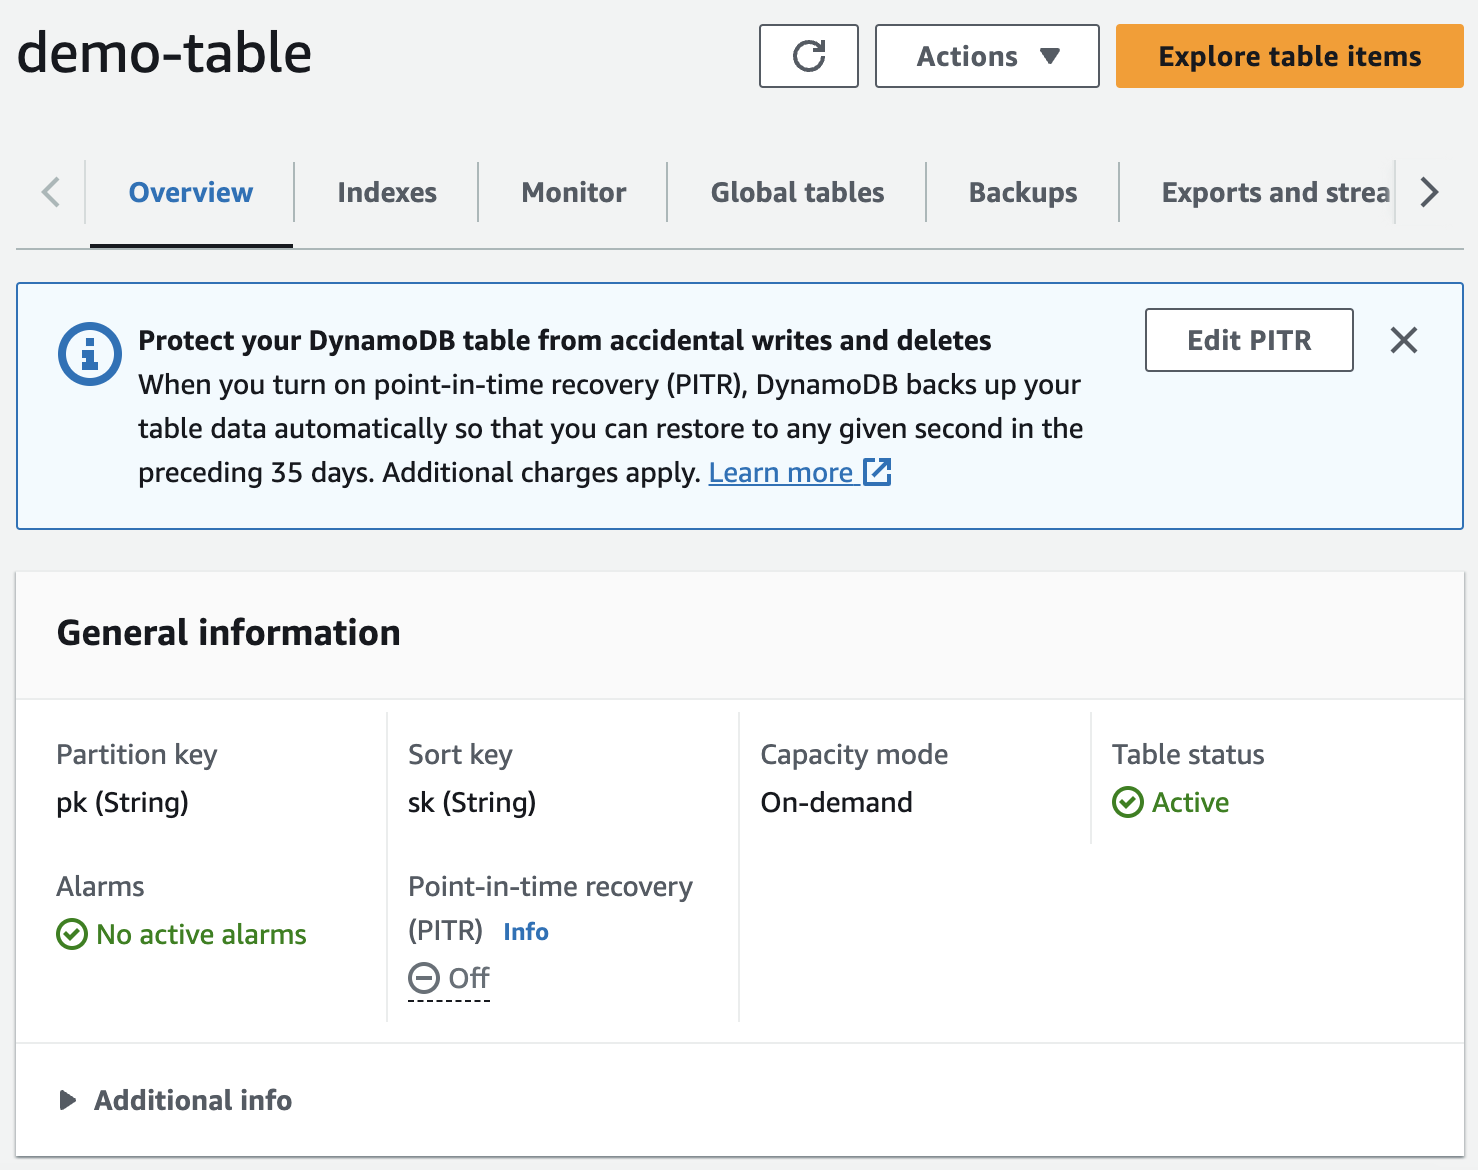
Trataré los modos de facturación de DynamoDB, WCU y RCU en un artículo aparte
client.ts
import { DynamoDB } from "@aws-sdk/client-dynamodb";


export const TABLE_NAME = "demo-table";
export const REGION = "eu-west-1";
export const dynamoClient = new DynamoDB({ region: REGION });


export const STUDENT_PREFIX = "student#";
Modelo de datos
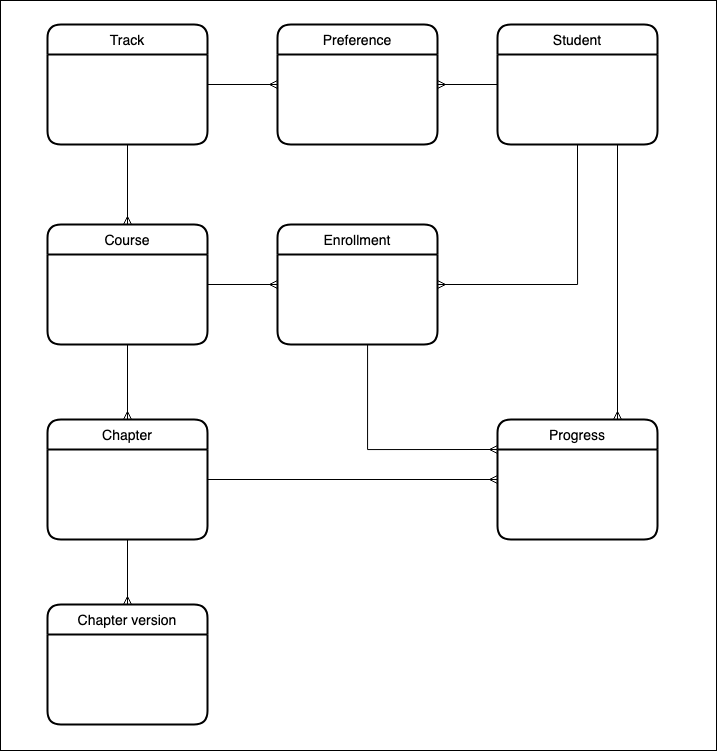
Antes de continuar, definamos un modelo de datos que usaremos en el alcance de este tutorial. Para mantener el contexto, he optado por modelar algo cercano a las funciones principales de DataCamp.
Este tutorial no cubrirá todas las entidades. Ampliaré este modelo en artículos posteriores.
Operaciones CRUD con DynamoDB
Para entender a fondo cómo diseñar y modelar datos con DynamoDB, consulta mi tutorial sobre diseño de tabla única con DynamoDB. En este tutorial intentaré reducir al mínimo la explicación del funcionamiento interno de DynamoDB. Lo importante es recordar que DynamoDB usa claves de partición y de ordenación para gestionar datos de forma eficiente.
Claves de partición
Las claves de partición se usan para distribuir datos entre varios servidores de almacenamiento. Es importante elegir una clave de partición que distribuya los datos de forma uniforme para evitar "particiones calientes" (distribución desigual) que puedan generar problemas de rendimiento.
Opciones habituales de claves de partición que ayudan a distribuir de forma homogénea incluyen atributos de alta cardinalidad como:
- IDs únicos
- IDs de usuario
- valores hash
- regiones geográficas
- claves basadas en tiempo
- claves compuestas
La elección de la clave de partición dependerá en gran medida de los patrones de acceso y del modelo de datos de la aplicación.
Claves de ordenación
Las claves de ordenación son opcionales y te permiten organizar los datos dentro de una partición. Úsalas para consultar y ordenar eficientemente dentro de una partición.
Claves compuestas
Las claves compuestas constan de clave de partición y de ordenación. Permiten crear patrones de consulta avanzados, como filtrado por rangos, por tiempo u otros atributos. Úsalas cuando tus patrones de acceso requieran consultas complejas.
Particiones calientes
Para mitigar las particiones calientes, considera estrategias como sharding (añadir prefijos aleatorios a las claves de partición), particionado por tiempo o distribuir las escrituras de forma uniforme. Supervisa y usa Auto Scaling de AWS para ajustar la capacidad dinámicamente.
student.ts
Vamos a simplificar y usar el ID del estudiante tanto como clave de partición como de ordenación. Puede parecer una elección extraña, pero necesitamos mantener el esquema flexible y listo para soportar distintas relaciones de datos y patrones de acceso. Ampliaré este modelo en próximos artículos sobre DynamoDB.
import { head, omit, pathOr } from "ramda";
import { STUDENT_PREFIX, TABLE_NAME, dynamoClient as client } from "../client";
import { v4 as uuidv4 } from "uuid";
import {
  addPrefix,
  attributeMapToValues,
  attributeValueToValue,
  removePrefix,
  valueToAttributeValue,
} from "../utils";


const entityType = "student";


export const dynamoRecordToStudent = (record: any) => {
  const { pk, ...data } = record;


  return omit(["sk"], {
    ...attributeMapToValues(data),
    id: removePrefix(attributeValueToValue<string>(pk), STUDENT_PREFIX),
  });
};


export const getStudentById = (id: string) =>
  client
    .getItem({
      TableName: TABLE_NAME,
      Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
  })
  .then(({ Item }) => (Item ? dynamoRecordToStudent(Item) : undefined));


export const saveStudent = async ({
  firstName,
  lastName,
  email,
}: {
  firstName: string;
  lastName: string;
  email: string;
}): Promise<string> => {
  const _id = uuidv4();
  const _email = email.toLocaleLowerCase();
  const xp = 0;


  await client.putItem({
    TableName: TABLE_NAME,
    Item: {
      pk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      firstName: valueToAttributeValue(firstName),
      lastName: valueToAttributeValue(lastName),
      email: valueToAttributeValue(_email),
      xp: valueToAttributeValue(xp),
      entityType: valueToAttributeValue(entityType),
    },
  });


  return _id;
};
utils.ts
La versión más reciente del SDK de DynamoDB de AWS ha aumentado la seguridad de tipos para los elementos almacenados en la base de datos, pero esto también ha hecho que trabajar con él sea un poco más engorroso. Para facilitarlo, creemos algunas funciones auxiliares. Más adelante verás por qué las necesitamos cuando observemos cómo almacena los datos internamente DynamoDB.
Crea un archivo nuevo en la raíz de la carpeta src llamado utils.ts.
import { AttributeValue } from "@aws-sdk/client-dynamodb";


export const valueToAttributeValue = <T>(value: T): AttributeValue => {
  switch (typeof value) {
    case "string":
      return { S: value };
    case "number":
      return { N: `${value}` };
    case "boolean":
      return { BOOL: value };
    case "object":
      if (Array.isArray(value)) {
        return { L: value.map((item) => valueToAttributeValue(item)) };
      }
      return {
        M: Object.entries(value as any).reduce(
          (acc, [key, item]) => ({
            ...acc,
            [key]: valueToAttributeValue(item),
          }),
          {}
        ),
      };
    default:
      throw new Error(`Unknown type ${typeof value}`);
  }
};


export const attributeValueToValue = <T>(value: AttributeValue): T => {
  switch (true) {
    case !!value.S:
      return value.S as T;
    case !!value.N:
      return Number(value.N) as T;
    case !!value.BOOL:
      return value.BOOL as T;
    case !!value.L:
      return value.L?.map((item) =>
        attributeValueToValue(item)
      ) as unknown as T;
    case !!value.M:
      return Object.entries(value.M || []).reduce(
        (acc, [key, item]) => ({ ...acc, [key]: attributeValueToValue(item) }),
        {}
      ) as unknown as T;
    default:
      throw new Error(`Unknown type ${JSON.stringify(value)}`);
  }
};


export const attributeMapToValues = (
  items: Record<string, AttributeValue>
): unknown[] =>
  Object.keys(items).reduce(
    (acc, key) => ({
      ...acc,
      [key]: attributeValueToValue(items[key]),
    }),
    []
  );


export const removePrefix = (id: string, prefix: string): string =>
  id.replace(prefix, "");


export const addPrefix = (id: string, prefix: string): string =>
  `${prefix}${removePrefix(id, prefix)}`;
Crear un nuevo estudiante
¡Por fin estamos listos para empezar a enviar llamadas de API de operaciones CRUD a DynamoDB!
Abre el archivo index.ts, pega el siguiente código y, desde la consola, ejecuta yarn dev.
import { getStudentById, saveStudent } from "./domain/student";


Promise.resolve()
  .then(async () => {
    const id = await saveStudent({
      firstName: "John",
      lastName: "Smith",
      email: "john@datacamp.com",
    });


    const john = await getStudentById(id);


    console.log(john);
  })
  .catch((err) => {
    console.error(err);
    process.exit(1);
  })
  .then(() => {
    console.log("done");
    process.exit(0);
  });
Deberías ver algo parecido a esto:
{
  "entityType": "student",
  "id": "dd4c2ee4-9422-4957-ae6f-f9fff748e5ab",
  "firstName": "John",
  "lastName": "Smith",
  "email": "john@datacamp.com",
  "xp": 0
}
Ahora usa la CLI para escanear DynamoDB ejecutando:
aws dynamodb scan --table-name demo-table --no-cli-pager
En la salida puedes ver cómo DynamoDB almacena y tipa los datos internamente: N se refiere a un número y S a una cadena. Esto debería aclarar cualquier duda que tuvieras sobre el código de utils.ts.
{
  "Items": [
    {
      "entityType": {
        "S": "student"
      },
      "lastName": {
        "S": "Smith"
      },
      "email": {
        "S": "john@datacamp.com"
      },
      "xp": {
        "N": "0"
      },
      "sk": {
        "S": "student#dd4c2ee4-9422-4957-ae6f-f9fff748e5ab"
      },
      "pk": {
        "S": "student#dd4c2ee4-9422-4957-ae6f-f9fff748e5ab"
      },
      "firstName": {
        "S": "John"
      }
    }
  ],
  "Count": 1,
  "ScannedCount": 1,
  "ConsumedCapacity": null
}
Obtener un estudiante por correo electrónico
¿Y si solo tuviésemos la dirección de correo del estudiante para encontrar su registro? Podemos soportar este patrón de acceso añadiendo un índice global secundario.
Primero, necesitamos destruir la tabla original (en cambios futuros de terraform evitaremos este paso introduciendo una función para truncar la tabla):
terraform destroy
Después, actualiza terraform añadiendo el siguiente GSI a nuestra demo-table:
attribute {
  name = "gsi1_pk"
  type = "S"
}


attribute {
  name = "gsi1_sk"
  type = "S"
}


global_secondary_index {
  name = "gsi1"
  hash_key = "gsi1_pk"
  range_key = "gsi1_sk"
  projection_type = "ALL"
}
Aplica el cambio con:
terraform apply -auto-approve
A continuación, necesitamos modificar ligeramente cómo guardamos un estudiante:
export const saveStudent = async ({
  firstName,
  lastName,
  email,
}: {
  firstName: string;
  lastName: string;
  email: string;
}): Promise<string> => {
  const _id = uuidv4();
  const _email = email.toLocaleLowerCase();
  const xp = 0;


  await client.putItem({
    TableName: TABLE_NAME,
    Item: {
      pk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      gsi1_pk: valueToAttributeValue(_email),
      gsi1_sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      firstName: valueToAttributeValue(firstName),
      lastName: valueToAttributeValue(lastName),
      xp: valueToAttributeValue(xp),
      entityType: valueToAttributeValue(entityType),
    },
  });


  return _id;
};
Fíjate en que ya no almacenamos explícitamente el email, sino que lo usamos como nuestro valor de PK del GSI.
También tenemos que retocar cómo transformamos los datos del estudiante desde DynamoDB:
export const dynamoRecordToStudent = (record: any) => {
  const { pk, gsi1_pk, ...data } = record;


  return omit(["sk", "gsi1_sk"], {
    ...attributeMapToValues(data),
    id: removePrefix(attributeValueToValue<string>(pk), STUDENT_PREFIX),
    email: attributeValueToValue<string>(gsi1_pk),
  });
};
Por último, podemos consultar con nuestro GSI recién creado, gsi1, para obtener un registro de estudiante por correo electrónico:
export const getStudentByEmail = (email: string) =>
  client
    .query({
      TableName: TABLE_NAME,
      IndexName: "gsi1",
      KeyConditionExpression: "#gsi1_pk = :gsi1_pk",
      ExpressionAttributeNames: {
        "#gsi1_pk": "gsi1_pk",
      },
      ExpressionAttributeValues: {
        ":gsi1_pk": {
          S: email.toLocaleLowerCase(),
        },
      },
    })
    .then((res) => head(pathOr([], ["Items"], res).map(dynamoRecordToStudent)));
Actualizar un estudiante
Para actualizar un estudiante necesitamos usar el método update y proporcionar tanto la clave de partición como la de ordenación para identificar de forma única el elemento que queremos actualizar.
export const updateStudent = async ({
  id,
  firstName,
  lastName,
  email,
}: {
  id: string;
  firstName?: string;
  lastName?: string;
  email?: string;
}) => {
  const updateExpressionParts = [];
  const ExpressionAttributeValues: Record<string, any> = {};


  if (firstName !== undefined) {
    updateExpressionParts.push("#firstName = :firstName");
    ExpressionAttributeValues[":firstName"] = valueToAttributeValue(firstName);
  }


  if (lastName !== undefined) {
    updateExpressionParts.push("#lastName = :lastName");
    ExpressionAttributeValues[":lastName"] = valueToAttributeValue(lastName);
  }


  if (email !== undefined) {
    updateExpressionParts.push("#gsi1_pk = :gsi1_pk");
    ExpressionAttributeValues[":gsi1_pk"] = valueToAttributeValue(email);
  }


  const UpdateExpression = `SET ${updateExpressionParts.join(", ")}`;


  const ExpressionAttributeNames = {
    ...(firstName && { "#firstName": "firstName" }),
    ...(lastName && { "#lastName": "lastName" }),
    ...(email && { "#gsi1_pk": "gsi1_pk" }),
  };


  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression,
    ExpressionAttributeNames,
    ExpressionAttributeValues,
  });
};
Eliminar datos
Empecemos aclarando que truncar una tabla en DynamoDB no está soportado de forma nativa, salvo borrando la tabla entera y creándola de nuevo (como tuvimos que hacer antes para introducir un nuevo GSI). Voy a añadir un método de truncado a nuestro client.ts, pero quiero recalcar que es solo para pruebas y no debe usarse en producción. La razón es que, para saber qué borrar, hay que escanear la tabla completa, y cada operación en DynamoDB tiene coste; si tienes una tabla con un millón de elementos, te saldrá más barato eliminarla y empezar de nuevo (con algún proceso de migración de datos para no perder información de producción). Aquí tienes nuestra función de truncado:
type AttributeMap = Record<string, AttributeValue>;


const getItemKeyAndValue = (item: AttributeMap, key?: string) =>
  key ? { [`${key}`]: item[`${key}`] } : {};


export const truncateTable = async (
  client: DynamoDB,
  TableName: string,
  hash: string,
  range?: string
): Promise<void> => {
  const { Items } = await client.scan({ TableName });
  if (!Items) {
    return;
  }
  const keys = Items.map((item: AttributeMap) => ({
    ...getItemKeyAndValue(item, hash),
    ...getItemKeyAndValue(item, range),
  }));
  if (!keys.length) {
    return;
  }
  await Promise.all(keys?.map((Key) => client.deleteItem({ TableName, Key })));
};
Para truncar la demo-table:
await truncateTable(dynamoClient, TABLE_NAME, "pk", "sk");
Para eliminar un estudiante concreto, en realidad no nos interesa usar el método deleteItem del SDK. Las bases de datos NoSQL no tienen concepto de integridad referencial y, si hubiese otros elementos en nuestra base que apuntasen a un estudiante que ya no existe, tendríamos un problema: DynamoDB eliminará sin rechistar cualquier elemento que le indiquemos, sin la red de seguridad de claves externas que tendría una base de datos relacional (que lanzaría un error en esa operación de borrado).
Para ir sobre seguro, implementaremos un borrado lógico (soft delete) y haremos una pequeña modificación en nuestras dos funciones de lectura.
export const deleteStudent = async (id: string) => {
  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression: "SET #deleted = :deleted",
    ExpressionAttributeNames: {
      "#deleted": "deleted",
    },
    ExpressionAttributeValues: {
      ":deleted": valueToAttributeValue(true),
    },
  });
};
La consulta de getStudentByEmail ahora debe filtrar los registros eliminados. Es importante destacar que este "filtrado" ocurre en el cliente y no en la base de datos, por lo que esta consulta seguirá incurriendo en el mismo coste por recuperar registros eliminados.
{
  TableName: TABLE_NAME,
  IndexName: "gsi1",
  KeyConditionExpression: "#gsi1_pk = :gsi1_pk",
  ExpressionAttributeNames: {
    "#gsi1_pk": "gsi1_pk",
  },
  ExpressionAttributeValues: {
    ":gsi1_pk": {
      S: email.toLocaleLowerCase(),
    },
    ":notDeleted": {
      BOOL: false,
    },
  },
  FilterExpression:
    "attribute_not_exists(deleted) OR deleted = :notDeleted",
 }
La función getStudentById usa getItem, así que no tenemos opción de aplicar una expresión de filtro; en su lugar, escribiremos la lógica explícitamente:
export const getStudentById = (id: string): Promise<Student | null> =>
  client
    .getItem({
      TableName: TABLE_NAME,
      Key: {
        pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
        sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      },
    })
    .then(({ Item }) => {
      if (!Item) {
        return null;
      }
      const _item = dynamoRecordToStudent(Item);
      return _item.deleted ? null : _item;
    });
Actualizaciones atómicas con cumplimiento ACID
DataCamp recopila el XP de cada estudiante para aportar motivación, una sensación de logro, una forma sencilla de seguir el progreso general y un medio para que los estudiantes se comparen con sus pares. En una base de datos relacional disponemos de varias herramientas para manipular y agregar datos, pero no es el caso en las NoSQL. Aunque algunas NoSQL como MongoDB ofrecen un framework de agregación, estas herramientas suelen quedarse cortas a gran escala, y precisamente se elige NoSQL cuando necesitamos soportar volúmenes y tráfico muy altos.
En DynamoDB, las actualizaciones atómicas son la capacidad de realizar ciertas operaciones de actualización sobre un único atributo de un elemento de forma que se garantizan la atomicidad, consistencia, aislamiento y durabilidad (propiedades ACID). Son operaciones que modifican el valor de un atributo concreto asegurando su éxito incluso con actualizaciones concurrentes.
Con esta técnica podemos sumar fácilmente XP cuando un usuario completa un objetivo de aprendizaje.
export const updateStudentXp = async ({
  id,
  xp,
}: {
  id: string;
  xp: number;
}) => {
  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression: "set xp = xp + :inc",
    ExpressionAttributeValues: {
      ":inc": valueToAttributeValue(xp),
    },
  });
};
Si este código te suena, es porque ya usamos este patrón en la función deleteStudent.
Conclusión
En este tutorial hemos explorado los fundamentos de Amazon DynamoDB, una base de datos sin servidor y altamente escalable de AWS. Sus características clave, como la escalabilidad transparente, la alta disponibilidad y el modelado flexible, la convierten en una gran opción para aplicaciones modernas.
Hemos cubierto temas esenciales como crear tablas, realizar operaciones CRUD con Node.js y la importancia de las actualizaciones atómicas para mantener la consistencia de los datos. A lo largo del tutorial, desarrollamos un modelo de datos e implementamos funciones para interactuar con DynamoDB.
A medida que sigas profundizando en DynamoDB, considera abordar temas avanzados como el diseño de tabla única, la optimización del rendimiento y DynamoDB Streams para procesamiento de datos en tiempo real. La versatilidad y escalabilidad de DynamoDB te permiten crear aplicaciones sin servidor y de alto rendimiento dentro del ecosistema de AWS.
Puedes encontrar el código fuente completo de este tutorial en GitHub. ¡Feliz programación!
Material adicional para seguir aprendiendo
- Tutorial de DataCamp: Diseño de tabla única con DynamoDB
- Curso de DataCamp: Conceptos de NoSQL
- AWS re:Invent: Patrones de diseño avanzados para DynamoDB
- Rick Houlihan: Fundamentos del diseño de tabla única en DynamoDB
- Alex DeBrie: el libro de DynamoDB