In einer datengetriebenen Welt sind skalierbare, performante und hochverfügbare Datenbanken gefragter denn je. Amazon DynamoDB, ein vollständig verwalteter, serverloser Wide-Column-Key-Value-Store von AWS (Amazon Web Services), ist genau dafür gebaut. Ob Web-App, Mobile-App oder jedes System mit flexiblem und zuverlässigem Speicherbedarf – mit DynamoDB bist du bestens aufgestellt.
Dieses Tutorial führt dich in Amazon DynamoDB ein und zeigt, wie du es effektiv in Node.js-Anwendungen einsetzt. Egal, ob du gerade erst mit NoSQL-Datenbanken beginnst oder als erfahrene:r Entwickler:in deinen Kompetenzbereich erweitern willst – dieser Leitfaden erklärt die Grundlagen und liefert praxisnahe Beispiele für den schnellen Einstieg.
Was ist DynamoDB?
Amazon DynamoDB ist eine serverlose Key-Value- und Dokumentendatenbank mit nahtloser Skalierung und geringer Latenz. Anders als bei klassischen relationalen Datenbanken musst du keine Hardware bereitstellen oder Infrastruktur managen. Damit ist DynamoDB ideal für Anwendungen, die je nach Last dynamisch hoch- oder runterskalieren müssen.
Zu den wichtigsten Features von DynamoDB zählen:
Skalierbarkeit
DynamoDB verarbeitet Millionen Anfragen pro Sekunde und eignet sich damit für Anwendungen mit stark schwankendem Traffic.
Hohe Verfügbarkeit
Auf hohe Verfügbarkeit und Datenbeständigkeit ausgelegt – mit integrierter Replikation über mehrere Availability Zones.
Vollständig verwaltet
AWS übernimmt den Betriebsaufwand wie Hardwarebereitstellung, Patching und Backups. So kannst du dich ganz auf den Aufbau deiner Anwendung konzentrieren.
Flexibles Datenmodell
DynamoDB unterstützt Key-Value- und Dokumentenmodelle und gibt dir damit viel Freiheit bei der Datenstruktur.
Sicherheit
Die Integration mit AWS Identity and Access Management (IAM) ermöglicht fein granulierte, sichere Zugriffskontrolle auf Datenbankressourcen bis auf Item- und Attributebene.
Kostenvorteile
Durch die serverlose Architektur und automatisches Skalieren zahlst du nur, was du wirklich nutzt – ohne Vorabkosten für Hardware oder langfristige Bindungen. Das macht DynamoDB für Start-ups ebenso attraktiv wie für große Unternehmen.
Datentypen
Unterstützte Datentypen in DynamoDB:
- Skalare Typen: Dazu gehören Strings, Zahlen, Binärwerte, Booleans und Null.
- Dokumenttypen: DynamoDB verarbeitet komplexe Strukturen mit verschachtelten Attributen – ideal für JSON-Daten.
- Mengen (Sets): String-, Zahlen- und Binärmengen ermöglichen effizientes Speichern zusammengehöriger Werte.
Warum DynamoDB mit Node.js nutzen?
Node.js ist ein populäres Laufzeitumfeld für Serveranwendungen wie Webserver und APIs. Seine nicht-blockierende, ereignisgesteuerte Architektur passt perfekt zur asynchronen API von DynamoDB – eine natürliche Wahl für Node.js-Entwickler:innen.
In diesem Tutorial behandeln wir:
1. Das Anlegen von Tabellen und das Definieren eines Schemas in DynamoDB.
2. Basis-CRUD-Operationen (Create, Read, Update, Delete) mit dem AWS SDK für Node.js.
3. Erweiterte Abfragen mit ACID-Eigenschaften.
Am Ende hast du ein solides Verständnis von Amazon DynamoDB und weißt, wie du die Stärken der Datenbank in deinen Node.js-Anwendungen nutzt. Legen wir los und holen das Beste aus dieser vielseitigen NoSQL-Datenbank heraus!
Vorbereitung
Bevor wir starten, brauchst du ein AWS-Konto. Wir könnten alles auch ohne AWS-Konto demonstrieren, aber für ein realistischeres Beispiel verwenden wir terraform, um unsere Infrastruktur in AWS aufzubauen. Wenn du lokale Entwicklung mit AWS-Services per Docker erkunden willst, findest du ein Beispiel-Demo mit localstack im GitHub-Repository – ideal zum Ausprobieren.
Installiere jetzt auch terraform, falls noch nicht vorhanden.
Im weiteren Verlauf gehen wir davon aus, dass du die AWS CLI mit deinen Zugangsdaten und Konfigurationsdateien eingerichtet und terraform installiert hast.
Erste Schritte
Für dieses Tutorial verwenden wir TypeScript und Yarn. Wir starten einfach mit ts-node und gehen im nächsten Teil serverlos weiter – dann mit AWS Lambda.
Lege für das Demoprojekt einen neuen Ordner an und installiere folgende Abhängigkeiten. Führe dazu aus:
yarn init
yarn add --dev typescript ts-node @types/node @types/ramda @types/uuid
yarn add @aws-sdk/client-dynamodb ramda uuid
npx tsc --init
mkdir src src/domain infra
touch ./src/index.ts ./src/client.ts ./infra/main.tf ./src/domain/student.ts
Ergänze anschließend in der package.json den folgenden scripts-Abschnitt:
  "scripts": {
    "dev": "ts-node src/index.ts"
  },
main.tf
provider "aws" {
  region = "eu-west-1"
}


resource "aws_dynamodb_table" "demo-table" {
  name = "demo-table"
  billing_mode = "PAY_PER_REQUEST"
  hash_key = "pk"
  range_key = "sk"


  attribute {
    name = "pk"
    type = "S"
  }


  attribute {
    name = "sk"
    type = "S"
  }
}
Wechsle im Terminal in das Verzeichnis infra und führe terraform init && terraform apply -auto-approve aus. Öffne anschließend die AWS-Konsole und sieh dir deine DynamoDB-Tabelle an:
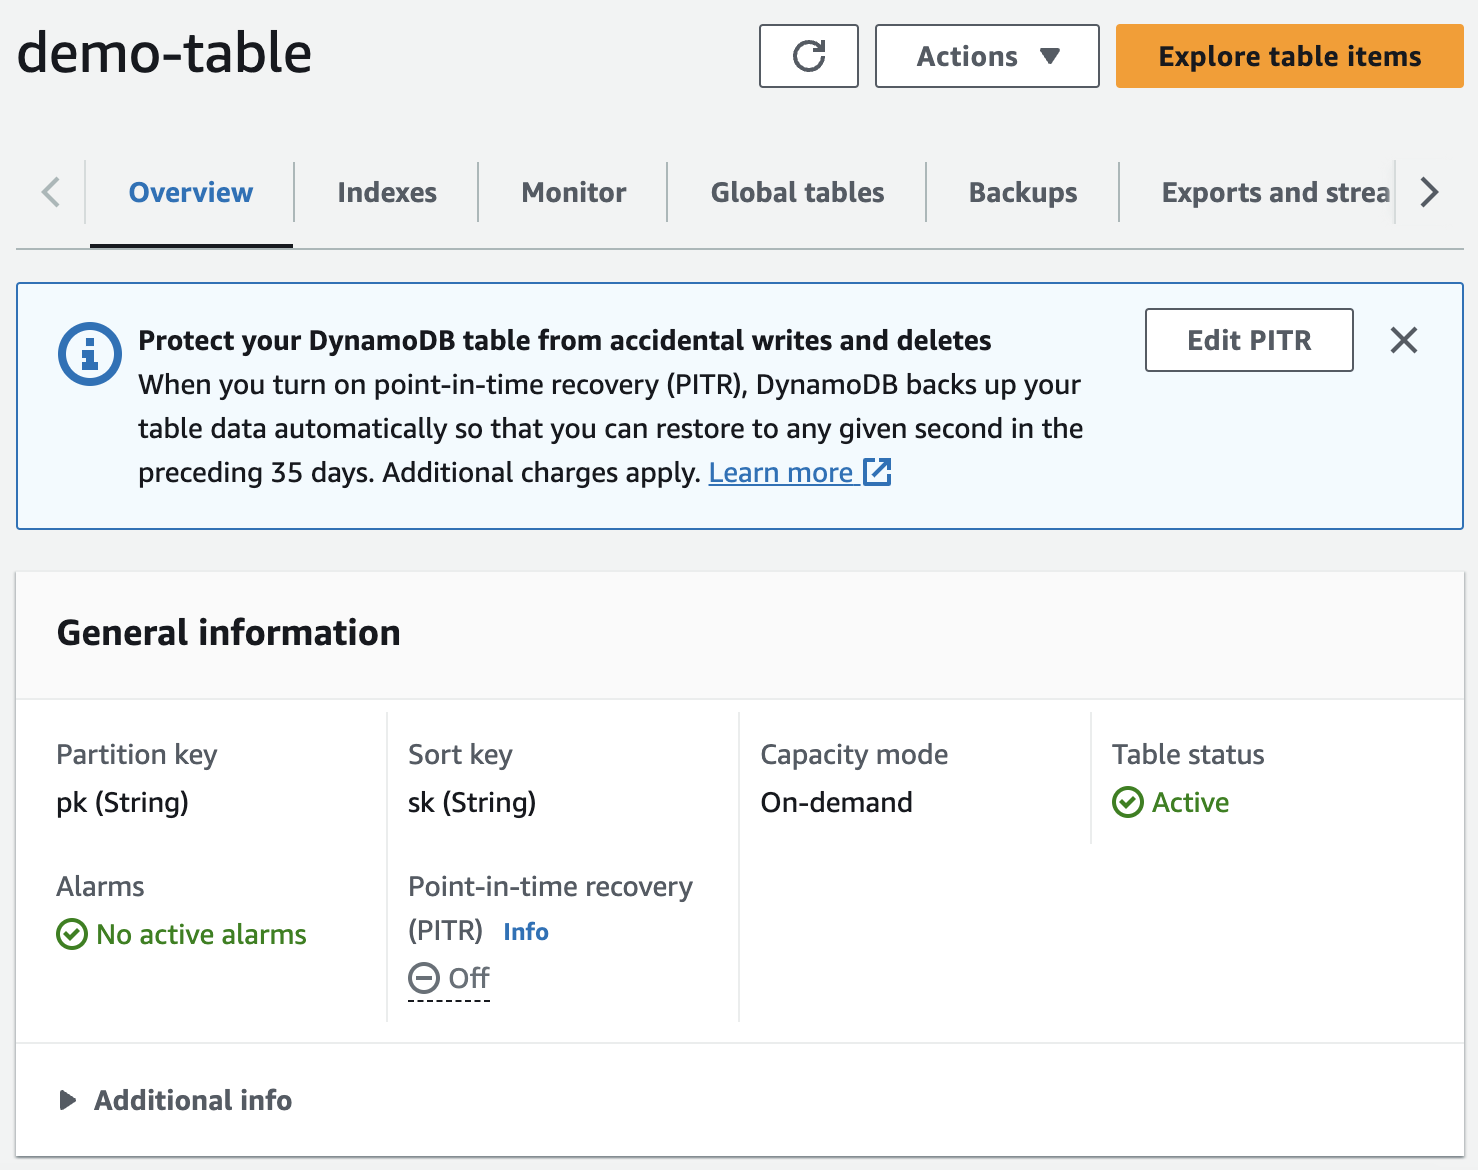
Auf Abrechnungsmodi von DynamoDB, WCU und RCU gehe ich in einem separaten Artikel ein.
client.ts
import { DynamoDB } from "@aws-sdk/client-dynamodb";


export const TABLE_NAME = "demo-table";
export const REGION = "eu-west-1";
export const dynamoClient = new DynamoDB({ region: REGION });


export const STUDENT_PREFIX = "student#";
Datenmodell
Bevor wir weitermachen, definieren wir ein Datenmodell für den Rahmen dieses Tutorials. Zur Einordnung habe ich mich für ein Modell entschieden, das den Kernfunktionen von DataCamp nahekommt.
Dieses Tutorial deckt nicht alle Entitäten ab. Ich erweitere das Modell in kommenden Artikeln.
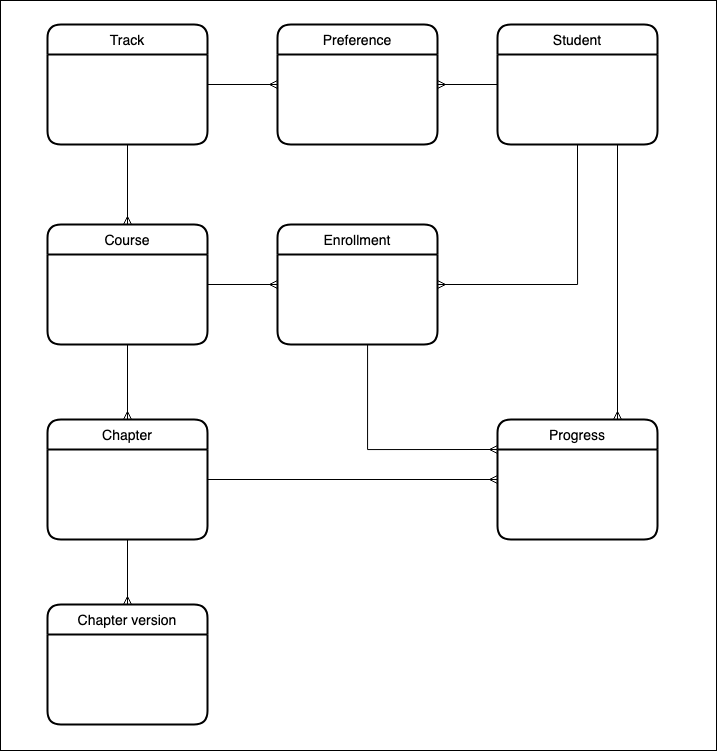
CRUD-Operationen mit DynamoDB
Eine umfassende Einführung in Datenmodellierung und Design mit DynamoDB findest du in meinem Tutorial zur Single-Table-Architektur mit DynamoDB. Hier halte ich die Funktionsweise von DynamoDB bewusst knapp. Wichtig ist: DynamoDB nutzt Partition Keys und Sort Keys für effizientes Datenmanagement.
Partition Keys
Partition Keys verteilen Daten auf mehrere Speicherserver. Wähle einen Schlüssel, der deine Daten gleichmäßig verteilt, um „heiße Partitionen“ (ungleiche Verteilung) und damit Performanceprobleme zu vermeiden.
Gut geeignete Attribute mit hoher Kardinalität sind z. B.:
- Eindeutige IDs
- User-IDs
- Hash-Werte
- Regionen
- Zeitbasierte Schlüssel
- Verbundschlüssel
Die Wahl des Partition Keys hängt stark von deinen Zugriffsmustern und dem Datenmodell ab.
Sort Keys
Sort Keys sind optional und ordnen Daten innerhalb einer Partition. Nutze sie für effiziente Abfragen und Sortierung innerhalb der Partition.
Verbundschlüssel
Verbundschlüssel bestehen aus Partition und Sort Key. Sie ermöglichen reichhaltige Abfragemuster, etwa nach Bereichen, Zeit oder anderen Attributen. Setze sie ein, wenn deine Zugriffsmuster komplexe Abfragen erfordern.
Heiße Partitionen
Zur Vermeidung heißer Partitionen helfen Strategien wie Sharding (zufällige Präfixe für Partition Keys), zeitbasierte Partitionierung oder gleichmäßiges Verteilen der Schreibvorgänge. Überwache deine Workloads und nutze AWS Auto Scaling für dynamische Kapazitätsanpassung.
student.ts
Wir halten es einfach und verwenden die Student-ID als Partition und Sort Key. Das wirkt zunächst ungewohnt, hält aber das Schema flexibel und bereit für unterschiedliche Datenbeziehungen und Zugriffsmuster. Ich erweitere dieses Modell in kommenden DynamoDB-Artikeln.
import { head, omit, pathOr } from "ramda";
import { STUDENT_PREFIX, TABLE_NAME, dynamoClient as client } from "../client";
import { v4 as uuidv4 } from "uuid";
import {
  addPrefix,
  attributeMapToValues,
  attributeValueToValue,
  removePrefix,
  valueToAttributeValue,
} from "../utils";


const entityType = "student";


export const dynamoRecordToStudent = (record: any) => {
  const { pk, ...data } = record;


  return omit(["sk"], {
    ...attributeMapToValues(data),
    id: removePrefix(attributeValueToValue<string>(pk), STUDENT_PREFIX),
  });
};


export const getStudentById = (id: string) =>
  client
    .getItem({
      TableName: TABLE_NAME,
      Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
  })
  .then(({ Item }) => (Item ? dynamoRecordToStudent(Item) : undefined));


export const saveStudent = async ({
  firstName,
  lastName,
  email,
}: {
  firstName: string;
  lastName: string;
  email: string;
}): Promise<string> => {
  const _id = uuidv4();
  const _email = email.toLocaleLowerCase();
  const xp = 0;


  await client.putItem({
    TableName: TABLE_NAME,
    Item: {
      pk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      firstName: valueToAttributeValue(firstName),
      lastName: valueToAttributeValue(lastName),
      email: valueToAttributeValue(_email),
      xp: valueToAttributeValue(xp),
      entityType: valueToAttributeValue(entityType),
    },
  });


  return _id;
};
utils.ts
Das aktuelle DynamoDB SDK von AWS bietet stärkere Typsicherheit für gespeicherte Items, macht die Arbeit damit aber etwas umständlicher. Zur Abhilfe schreiben wir ein paar Helper-Funktionen. Später wird klar, warum wir sie brauchen – wenn wir sehen, wie DynamoDB Daten intern speichert.
Lege im src-Ordner eine neue Datei namens utils.ts an.
import { AttributeValue } from "@aws-sdk/client-dynamodb";


export const valueToAttributeValue = <T>(value: T): AttributeValue => {
  switch (typeof value) {
    case "string":
      return { S: value };
    case "number":
      return { N: `${value}` };
    case "boolean":
      return { BOOL: value };
    case "object":
      if (Array.isArray(value)) {
        return { L: value.map((item) => valueToAttributeValue(item)) };
      }
      return {
        M: Object.entries(value as any).reduce(
          (acc, [key, item]) => ({
            ...acc,
            [key]: valueToAttributeValue(item),
          }),
          {}
        ),
      };
    default:
      throw new Error(`Unknown type ${typeof value}`);
  }
};


export const attributeValueToValue = <T>(value: AttributeValue): T => {
  switch (true) {
    case !!value.S:
      return value.S as T;
    case !!value.N:
      return Number(value.N) as T;
    case !!value.BOOL:
      return value.BOOL as T;
    case !!value.L:
      return value.L?.map((item) =>
        attributeValueToValue(item)
      ) as unknown as T;
    case !!value.M:
      return Object.entries(value.M || []).reduce(
        (acc, [key, item]) => ({ ...acc, [key]: attributeValueToValue(item) }),
        {}
      ) as unknown as T;
    default:
      throw new Error(`Unknown type ${JSON.stringify(value)}`);
  }
};


export const attributeMapToValues = (
  items: Record<string, AttributeValue>
): unknown[] =>
  Object.keys(items).reduce(
    (acc, key) => ({
      ...acc,
      [key]: attributeValueToValue(items[key]),
    }),
    []
  );


export const removePrefix = (id: string, prefix: string): string =>
  id.replace(prefix, "");


export const addPrefix = (id: string, prefix: string): string =>
  `${prefix}${removePrefix(id, prefix)}`;
Einen neuen Student anlegen
Jetzt können wir endlich CRUD-API-Aufrufe an DynamoDB senden!
Öffne index.ts, füge den folgenden Code ein und führe in der Konsole yarn dev aus.
import { getStudentById, saveStudent } from "./domain/student";


Promise.resolve()
  .then(async () => {
    const id = await saveStudent({
      firstName: "John",
      lastName: "Smith",
      email: "john@datacamp.com",
    });


    const john = await getStudentById(id);


    console.log(john);
  })
  .catch((err) => {
    console.error(err);
    process.exit(1);
  })
  .then(() => {
    console.log("done");
    process.exit(0);
  });
Die Ausgabe sollte in etwa so aussehen:
{
  "entityType": "student",
  "id": "dd4c2ee4-9422-4957-ae6f-f9fff748e5ab",
  "firstName": "John",
  "lastName": "Smith",
  "email": "john@datacamp.com",
  "xp": 0
}
Scanne nun die DynamoDB-Tabelle per CLI mit:
aws dynamodb scan --table-name demo-table --no-cli-pager
An der Ausgabe siehst du, wie DynamoDB Daten intern speichert und typisiert: N steht für Number, S für String usw. Das beantwortet auch die offenen Fragen zum Code in utils.ts.
{
  "Items": [
    {
      "entityType": {
        "S": "student"
      },
      "lastName": {
        "S": "Smith"
      },
      "email": {
        "S": "john@datacamp.com"
      },
      "xp": {
        "N": "0"
      },
      "sk": {
        "S": "student#dd4c2ee4-9422-4957-ae6f-f9fff748e5ab"
      },
      "pk": {
        "S": "student#dd4c2ee4-9422-4957-ae6f-f9fff748e5ab"
      },
      "firstName": {
        "S": "John"
      }
    }
  ],
  "Count": 1,
  "ScannedCount": 1,
  "ConsumedCapacity": null
}
Einen Student über die E-Mail-Adresse finden
Was, wenn wir nur die E-Mail-Adresse haben, um den Datensatz zu finden? Dieses Zugriffsmuster lässt sich mit einem Global Secondary Index (GSI) abbilden.
Zuerst löschen wir die ursprüngliche Tabelle (für zukünftige terraform-Änderungen umgehen wir diesen Schritt mit einer Truncate-Funktion):
terraform destroy
Ergänze anschließend in terraform den folgenden GSI für unsere demo-table:
attribute {
  name = "gsi1_pk"
  type = "S"
}


attribute {
  name = "gsi1_sk"
  type = "S"
}


global_secondary_index {
  name = "gsi1"
  hash_key = "gsi1_pk"
  range_key = "gsi1_sk"
  projection_type = "ALL"
}
Wende die Änderung an mit:
terraform apply -auto-approve
Nun passen wir das Speichern eines Student leicht an:
export const saveStudent = async ({
  firstName,
  lastName,
  email,
}: {
  firstName: string;
  lastName: string;
  email: string;
}): Promise<string> => {
  const _id = uuidv4();
  const _email = email.toLocaleLowerCase();
  const xp = 0;


  await client.putItem({
    TableName: TABLE_NAME,
    Item: {
      pk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      gsi1_pk: valueToAttributeValue(_email),
      gsi1_sk: valueToAttributeValue(addPrefix(_id, STUDENT_PREFIX)),
      firstName: valueToAttributeValue(firstName),
      lastName: valueToAttributeValue(lastName),
      xp: valueToAttributeValue(xp),
      entityType: valueToAttributeValue(entityType),
    },
  });


  return _id;
};
Beachte: Wir speichern die E-Mail nicht mehr explizit als Attribut, sondern nutzen sie als GSI-PK.
Auch die Transformation der DynamoDB-Daten für Student passen wir leicht an:
export const dynamoRecordToStudent = (record: any) => {
  const { pk, gsi1_pk, ...data } = record;


  return omit(["sk", "gsi1_sk"], {
    ...attributeMapToValues(data),
    id: removePrefix(attributeValueToValue<string>(pk), STUDENT_PREFIX),
    email: attributeValueToValue<string>(gsi1_pk),
  });
};
Jetzt können wir den neu erstellten GSI gsi1 verwenden, um einen Student per E-Mail zu finden:
export const getStudentByEmail = (email: string) =>
  client
    .query({
      TableName: TABLE_NAME,
      IndexName: "gsi1",
      KeyConditionExpression: "#gsi1_pk = :gsi1_pk",
      ExpressionAttributeNames: {
        "#gsi1_pk": "gsi1_pk",
      },
      ExpressionAttributeValues: {
        ":gsi1_pk": {
          S: email.toLocaleLowerCase(),
        },
      },
    })
    .then((res) => head(pathOr([], ["Items"], res).map(dynamoRecordToStudent)));
Einen Student aktualisieren
Zum Aktualisieren verwenden wir update und geben Partition- und Sort Key an, um das Item eindeutig zu identifizieren.
export const updateStudent = async ({
  id,
  firstName,
  lastName,
  email,
}: {
  id: string;
  firstName?: string;
  lastName?: string;
  email?: string;
}) => {
  const updateExpressionParts = [];
  const ExpressionAttributeValues: Record<string, any> = {};


  if (firstName !== undefined) {
    updateExpressionParts.push("#firstName = :firstName");
    ExpressionAttributeValues[":firstName"] = valueToAttributeValue(firstName);
  }


  if (lastName !== undefined) {
    updateExpressionParts.push("#lastName = :lastName");
    ExpressionAttributeValues[":lastName"] = valueToAttributeValue(lastName);
  }


  if (email !== undefined) {
    updateExpressionParts.push("#gsi1_pk = :gsi1_pk");
    ExpressionAttributeValues[":gsi1_pk"] = valueToAttributeValue(email);
  }


  const UpdateExpression = `SET ${updateExpressionParts.join(", ")}`;


  const ExpressionAttributeNames = {
    ...(firstName && { "#firstName": "firstName" }),
    ...(lastName && { "#lastName": "lastName" }),
    ...(email && { "#gsi1_pk": "gsi1_pk" }),
  };


  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression,
    ExpressionAttributeNames,
    ExpressionAttributeValues,
  });
};
Daten löschen
Ein wichtiger Punkt vorab: Ein „Truncate“ einer DynamoDB-Tabelle gibt es nativ nicht, außer du löschst die gesamte Tabelle und legst sie neu an (so wie wir es für den neuen GSI gemacht haben). Ich ergänze in client.ts eine Truncate-Funktion – ausschließlich für Tests, nicht für Produktion. Grund: Um zu wissen, was gelöscht werden soll, müssen wir die komplette Tabelle scannen. Jede Operation in DynamoDB kostet. Bei einer Million Items ist es meist günstiger, die Tabelle zu entfernen und neu zu erstellen (inklusive Datenmigration, damit keine Produktivdaten verloren gehen). Hier die truncate-Funktion:
type AttributeMap = Record<string, AttributeValue>;


const getItemKeyAndValue = (item: AttributeMap, key?: string) =>
  key ? { [`${key}`]: item[`${key}`] } : {};


export const truncateTable = async (
  client: DynamoDB,
  TableName: string,
  hash: string,
  range?: string
): Promise<void> => {
  const { Items } = await client.scan({ TableName });
  if (!Items) {
    return;
  }
  const keys = Items.map((item: AttributeMap) => ({
    ...getItemKeyAndValue(item, hash),
    ...getItemKeyAndValue(item, range),
  }));
  if (!keys.length) {
    return;
  }
  await Promise.all(keys?.map((Key) => client.deleteItem({ TableName, Key })));
};
So leerst du die demo-table:
await truncateTable(dynamoClient, TABLE_NAME, "pk", "sk");
Zum Löschen eines einzelnen Student solltest du in der Regel nicht einfach deleteItem aus dem SDK verwenden. NoSQL-Datenbanken kennen keine referenzielle Integrität. Wenn andere Items auf einen nicht mehr existierenden Student verweisen, ist das problematisch. DynamoDB löscht auf Anweisung, ohne Sicherheitsnetz wie Fremdschlüsselprüfungen in relationalen Datenbanken.
Sicherer ist ein Soft Delete. Dazu passen wir unsere beiden Lese-Funktionen leicht an.
export const deleteStudent = async (id: string) => {
  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression: "SET #deleted = :deleted",
    ExpressionAttributeNames: {
      "#deleted": "deleted",
    },
    ExpressionAttributeValues: {
      ":deleted": valueToAttributeValue(true),
    },
  });
};
Die Abfrage für getStudentByEmail sollte gelöschte Datensätze herausfiltern. Wichtig: Dieses „Filtern“ passiert clientseitig, nicht in der Datenbank. Die Kosten für das Lesen gelöschter Items fallen also weiterhin an.
{
  TableName: TABLE_NAME,
  IndexName: "gsi1",
  KeyConditionExpression: "#gsi1_pk = :gsi1_pk",
  ExpressionAttributeNames: {
    "#gsi1_pk": "gsi1_pk",
  },
  ExpressionAttributeValues: {
    ":gsi1_pk": {
      S: email.toLocaleLowerCase(),
    },
    ":notDeleted": {
      BOOL: false,
    },
  },
  FilterExpression:
    "attribute_not_exists(deleted) OR deleted = :notDeleted",
 }
Die Funktion getStudentById nutzt getItem. Hier können wir keinen Filterausdruck anwenden, also ergänzen wir die Logik direkt:
export const getStudentById = (id: string): Promise<Student | null> =>
  client
    .getItem({
      TableName: TABLE_NAME,
      Key: {
        pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
        sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      },
    })
    .then(({ Item }) => {
      if (!Item) {
        return null;
      }
      const _item = dynamoRecordToStudent(Item);
      return _item.deleted ? null : _item;
    });
Atomare Updates mit ACID-Eigenschaften
DataCamp sammelt XP-Daten für jede:n Student:in – das motiviert, macht Fortschritt sichtbar und ermöglicht Vergleiche mit Peers. In relationalen Datenbanken gibt es viele Werkzeuge für Aggregationen; bei NoSQL ist das anders. Einige NoSQL-Systeme wie MongoDB bieten Aggregationen, stoßen bei sehr großen Datenmengen aber an Grenzen. Oft wählt man NoSQL genau wegen der Anforderungen an enormes Daten- und Traffic-Volumen.
In DynamoDB bezeichnen atomare Updates die Möglichkeit, ein Attribut eines Items so zu ändern, dass Atomarität, Konsistenz, Isolation und Dauerhaftigkeit (ACID) gewährleistet sind – selbst bei konkurrierenden Updates.
Mit dieser Technik können wir z. B. XP erhöhen, sobald eine Lernaufgabe abgeschlossen ist.
export const updateStudentXp = async ({
  id,
  xp,
}: {
  id: string;
  xp: number;
}) => {
  await client.updateItem({
    TableName: TABLE_NAME,
    Key: {
      pk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
      sk: valueToAttributeValue(addPrefix(id, STUDENT_PREFIX)),
    },
    UpdateExpression: "set xp = xp + :inc",
    ExpressionAttributeValues: {
      ":inc": valueToAttributeValue(xp),
    },
  });
};
Klingt vertraut? Genau: Dasselbe Muster haben wir schon bei deleteStudent verwendet!
Fazit
In diesem Tutorial haben wir die Grundlagen von Amazon DynamoDB kennengelernt – einer serverlosen, hochskalierbaren Datenbank von AWS. Mit nahtloser Skalierung, hoher Verfügbarkeit und flexiblem Datenmodell ist DynamoDB ideal für moderne Anwendungen.
Wir haben das Anlegen von Tabellen, CRUD-Operationen mit Node.js und die Bedeutung atomarer Updates für konsistente Daten behandelt. Dabei haben wir ein Datenmodell entworfen und Funktionen zur Interaktion mit DynamoDB implementiert.
Für deinen weiteren Weg bieten sich Themen wie Single-Table-Design, Performanceoptimierung und DynamoDB Streams für Echtzeitverarbeitung an. Die Vielseitigkeit und Skalierbarkeit von DynamoDB ermöglicht es dir, performante, serverlose Anwendungen im AWS-Ökosystem zu bauen.
Den vollständigen Quellcode zu diesem Tutorial findest du auf Github. Viel Spaß beim Coden!
Weiterführende Lernmaterialien
- DataCamp-Tutorial: Single-Table-Design mit DynamoDB
- DataCamp-Kurs: NoSQL-Konzepte
- AWS re:Invent: Advanced Design Patterns for DynamoDB
- Rick Houlihan: Fundamentals of DynamoDB Single Table Design
- Alex DeBrie: Das DynamoDB-Buch