
Khóa học
Làm việc với OpenAI API
3 giờ
184.8K
GPT-5 giới thiệu tham số mức nỗ lực suy luận mới cho phép bạn kiểm soát độ sâu suy nghĩ của mô hình trước khi trả lời. Bạn có thể chọn các mức minimal, low, medium, hoặc high tùy theo nhu cầu.
Mức tối thiểu phù hợp cho các tác vụ cần tốc độ như viết mã nhanh hoặc theo hướng dẫn đơn giản, trong khi mức vừa và cao cho phép suy luận tuần tự, kỹ lưỡng hơn. Sự linh hoạt này giúp bạn cân bằng độ trễ, chi phí và độ chính xác.
Trước tiên, cài đặt OpenAI Python SDK và đặt API key dưới dạng biến môi trường:
pip install openaiĐặt API key của bạn (thay bằng khóa thực tế):
export OPENAI_API_KEY="your_api_key_here"setx OPENAI_API_KEY "your_api_key_here"Hãy dùng Response API để tạo văn bản với mức nỗ lực suy luận “minimal”. Nghĩa là mô hình sẽ trả lời trực tiếp, không phân bổ token cho suy luận nội bộ.
import os
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

resp = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "minimal"},
)

print(resp.output_text)
Kết quả:
Guido van Rossum is known as the father (creator) of Python. He first released Python in 1991.Bạn cũng có thể kiểm tra tóm tắt mức dùng token để hiểu mô hình đã xử lý yêu cầu của bạn ra sao:
print(f"Input tokens: {resp.usage.input_tokens}")
print(f"  - Cached tokens: {resp.usage.input_tokens_details.cached_tokens}")
print(f"Output tokens: {resp.usage.output_tokens}")
print(f"  - Reasoning tokens: {resp.usage.output_tokens_details.reasoning_tokens}")
print(f"Total tokens: {resp.usage.total_tokens}")
Như thấy, số token dùng cho suy luận là 0 khi effort đặt ở mức minimal.
Input tokens: 13
  - Cached tokens: 0
Output tokens: 31
  - Reasoning tokens: 0
Total tokens: 44
Giờ hãy tăng mức nỗ lực suy luận lên "high" để xem suy luận nội bộ của mô hình thay đổi thế nào:
resp = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "high"},
)

print(resp.output_text)
Kết quả:
Guido van Rossum. He created Python and first released it in 1991.Kiểm tra lại mức dùng token:
print(f"Input tokens: {resp.usage.input_tokens}")
print(f"  - Cached tokens: {resp.usage.input_tokens_details.cached_tokens}")
print(f"Output tokens: {resp.usage.output_tokens}")
print(f"  - Reasoning tokens: {resp.usage.output_tokens_details.reasoning_tokens}")
print(f"Total tokens: {resp.usage.total_tokens}")
Ngay cả với câu hỏi đơn giản, mô hình đã dùng 192 token cho suy luận ở mức cao. Điều này cho thấy bạn có thể kiểm soát độ sâu suy luận để tối ưu chi phí, tốc độ hoặc độ chính xác khi cần.
Input tokens: 13
  - Cached tokens: 0
Output tokens: 216
  - Reasoning tokens: 192
Total tokens: 229Với GPT-5, bạn có thể trực tiếp kiểm soát độ dài câu trả lời qua tham số verbosity. Đặt ở mức low để có câu trả lời súc tích, medium để cân bằng chi tiết, hoặc high cho giải thích chuyên sâu. Điều này đặc biệt hữu ích khi sinh mã—mức thấp cho mã ngắn, sạch; mức cao sẽ kèm chú thích nội tuyến và lý giải chi tiết.
Bạn có thể kết hợp tham số verbosity với điều khiển reasoning để điều chỉnh câu trả lời đúng như bạn cần. Dù bạn muốn một câu ngắn, một câu trả lời dài hơn, hay một báo cáo đầy đủ, bạn đều có toàn quyền linh hoạt.
Mức “low” tạo ra câu trả lời ngắn gọn, trực tiếp.
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

resp = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "minimal"},
    text={"verbosity": "low"},
)

print(resp.output_text)
Kết quả:
Guido van Rossum.Mức “high” tạo ra câu trả lời chi tiết và có tính giải thích nhiều hơn.
resp = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "minimal"},
    text={"verbosity": "high"},
)

print(resp.output_text)
Kết quả:
Guido van Rossum is known as the "father of Python." He created Python in the late 1980s and released the first version (Python 0.9.0) in 1991. He also served for many years as Python's "Benevolent Dictator For Life" (BDFL), guiding the language's development.Một trong những nâng cấp lớn nhất của GPT-5 là khả năng truyền chuỗi suy nghĩ (CoT) giữa các lượt trong Responses API. Điều này có nghĩa mô hình ghi nhớ suy luận nội bộ từ các bước trước, tránh suy nghĩ lặp lại, cải thiện cả tốc độ lẫn độ chính xác.
Trong hội thoại nhiều lượt, đặc biệt khi dùng công cụ, chỉ cần truyền previous_response_id để giữ ngữ cảnh suy luận.
Yêu cầu đầu tiên hỏi “Ai là cha đẻ của Python?”, và yêu cầu thứ hai, liên kết với yêu cầu đầu qua previous_response_id, yêu cầu mô hình “Viết một bài blog về chủ đề đó” mà không nhắc lại đối tượng. Bằng cách truyền ID của phản hồi trước, mô hình giữ được ngữ cảnh suy luận.
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

first = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "minimal"},
    text={"verbosity": "low"},
)

followup = client.responses.create(
    model="gpt-5",
    previous_response_id=first.id,
    input="Write a blog on it.",
    reasoning={"effort": "medium"},
    text={"verbosity": "high"},
)

print(followup.output_text)
Kết quả là chúng ta nhận được một bài blog về cha đẻ của Python.
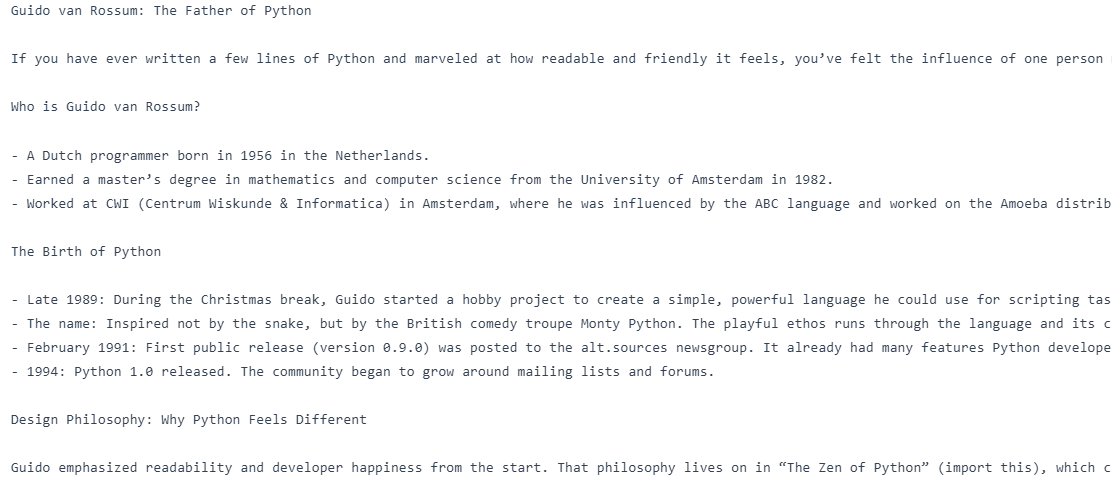
Các công cụ tùy chỉnh trong GPT-5 giờ hỗ trợ đầu vào tự do, cho phép mô hình gửi văn bản thô như mã, truy vấn SQL, hoặc lệnh shell trực tiếp tới công cụ của bạn. Đây là một bước tiến lớn so với cách tiếp cận chỉ JSON có cấu trúc trước đây, mang lại nhiều linh hoạt hơn trong cách mô hình tương tác với hệ thống của bạn. Dù bạn đang xây dựng bộ thực thi mã, công cụ truy vấn, hay trình thông dịch DSL, đầu vào tự do giúp GPT-5 thích ứng tốt hơn với các tác vụ thực tế, không có cấu trúc.
Trong đoạn mã dưới đây, chúng tôi định nghĩa một trình chạy SQL giả, đăng ký nó như một công cụ tùy chỉnh, và thực hiện yêu cầu ban đầu nơi mô hình phản hồi bằng một truy vấn SQL tự do. Truy vấn đó được trích xuất, thực thi cục bộ, và kết quả được gửi lại cho mô hình bằng cùng call_id để duy trì ngữ cảnh cuộc gọi công cụ. Cuối cùng, GPT‑5 chuyển đầu ra thô của công cụ thành câu trả lời ngôn ngữ tự nhiên.
from openai import OpenAI
import random

client = OpenAI()

def run_sql_query(sql: str) -> str:
    print("\n[FAKE DB] Executing SQL:\n", sql)
    categories = ["Electronics", "Clothing", "Furniture", "Toys", "Books"]
    result = "category   | total_sales\n" + "-" * 28 + "\n"
    for cat in categories:
        result += f"{cat:<11} | {random.randint(5000, 200000)}\n"
    return result


tools = [
    {
        "type": "custom",
        "name": "sql_query_runner",
        "description": "Runs raw SQL queries on the company sales database.",
    }
]

messages = [
    {
        "role": "user",
        "content": "Show me the total sales for each product category last month.",
    }
]

# 1) First call - model emits a freeform tool call
resp = client.responses.create(model="gpt-5", tools=tools, input=messages)

# IMPORTANT: carry the tool call into the next turn
messages += resp.output  # <-- this preserves the tool_call with its call_id

# Find the tool call from the response output
tool_call = next(
    (
        x
        for x in resp.output
        if getattr(x, "type", "") in ("custom_tool_call", "function_call", "tool_call")
    ),
    None,
)
assert tool_call is not None, "No tool call found."

# Freeform text is in input (fallback to arguments for safety) raw_text = getattr(tool_call, "input", None) or getattr(tool_call, "arguments", "") sql_text = raw_text.strip() # 2) Execute the tool locally fake_result = run_sql_query(sql_text) # 3) Send tool result back, referencing the SAME call_id messages.append( { "type": "function_call_output", "call_id": tool_call.call_id, "output": fake_result, } ) # 4) Final call - model turns tool output into a natural answer final = client.responses.create(model="gpt-5", tools=tools, input=messages) print("\nFinal output text:\n", final.output_text)
Kết quả:
[FAKE DB] Executing SQL:
 SELECT table_schema, table_name
FROM information_schema.tables
WHERE table_schema NOT IN ('information_schema','pg_catalog')
ORDER BY 1,2;

Final output text:
 Here are the total sales by category for last month (July 2025):

- Electronics: 31,766
- Clothing: 90,266
- Furniture: 55,471
- Toys: 124,625
- Books: 74,263

Want this as a CSV or chart?Trong các tình huống cần độ chính xác cao, GPT-5 hỗ trợ ngữ pháp phi ngữ cảnh (CFG) để kiểm soát chặt chẽ định dạng đầu ra. Bằng cách gắn kèm một ngữ pháp như cú pháp SQL hoặc ngôn ngữ chuyên biệt, bạn có thể đảm bảo phản hồi của mô hình luôn khớp cấu trúc yêu cầu. Điều này đặc biệt hữu ích cho quy trình tự động hoặc rủi ro cao, nơi chỉ một sai lệch nhỏ về định dạng cũng có thể gây lỗi.
Trong ví dụ mã, chúng tôi xây dựng công cụ sql_query_runner và định nghĩa cú pháp SQL của nó bằng ngữ pháp Lark, đảm bảo mọi SQL do mô hình tạo ra luôn hợp lệ và theo đúng cấu trúc của chúng tôi.
Trong cuộc gọi mô hình đầu tiên, GPT‑5 dùng công cụ này để tạo một truy vấn SQL tuân thủ ngữ pháp cho doanh số theo danh mục của tháng trước. Sau đó chúng tôi thực thi truy vấn cục bộ, gửi lại kết quả cho mô hình bằng cùng call_id, và thực hiện cuộc gọi thứ hai để GPT‑5 chuyển dữ liệu thô thành câu trả lời ngôn ngữ tự nhiên, rõ ràng.
from openai import OpenAI
import random

client = OpenAI()


def run_sql_query(sql: str) -> str:
    cats = ["Electronics", "Clothing", "Furniture", "Toys", "Books"]
    rows = [f"{c:<11} | {random.randint(5_000, 200_000)}" for c in cats]
    return "category   | total_sales\n" + "-" * 28 + "\n" + "\n".join(rows)


tools = [
    {
        "type": "custom",
        "name": "sql_query_runner",
        "description": "Runs raw SQL on the sales DB.",
        "format": {
            "type": "grammar",
            "syntax": "lark",
            "definition": r"""
start: SELECT CATEGORY COMMA SUM LPAREN SALES RPAREN AS TOTAL_SALES FROM ORDERS WHERE ORDER_MONTH EQ ESCAPED_STRING GROUP BY CATEGORY ORDER BY TOTAL_SALES (DESC|ASC)?

SELECT: "SELECT"
CATEGORY: "category"
COMMA: ","
SUM: "SUM"
LPAREN: "("
SALES: "sales"
RPAREN: ")"
AS: "AS"
TOTAL_SALES: "total_sales"
FROM: "FROM"
ORDERS: "orders"
WHERE: "WHERE"
ORDER_MONTH: "order_month"
EQ: "="
GROUP: "GROUP"
BY: "BY"
ORDER: "ORDER"
DESC: "DESC"
ASC: "ASC"

%import common.ESCAPED_STRING
%ignore /[ \t\r\n]+/
        """,
        },
    }
]

msgs = [
    {
        "role": "user",
        "content": "Show me the total sales for each product category last month.",
    }
]

print("\n=== 1) First Model Call ===")
resp = client.responses.create(
    model="gpt-5", input=msgs, tools=tools, text={"format": {"type": "text"}}
)
print("Raw model output objects:\n", resp.output)

msgs += resp.output
tool_call = next(
    x
    for x in resp.output
    if getattr(x, "type", "") in ("custom_tool_call", "function_call", "tool_call")
)
sql = (getattr(tool_call, "input", None) or getattr(tool_call, "arguments", "")).strip()
print("\nExtracted SQL from tool call:\n", sql)

print("\n=== 2) Local Tool Execution ===")
tool_result = run_sql_query(sql)
print(tool_result)

msgs.append(
    {
        "type": "function_call_output",
        "call_id": getattr(tool_call, "call_id", None) or tool_call["call_id"],
        "output": tool_result,
    }
)

print("\n=== 3) Second Model Call ===")
final = client.responses.create(
    model="gpt-5", input=msgs, tools=tools, text={"format": {"type": "text"}}
)
print("\nFinal natural-language answer:\n", final.output_text)
Như có thể thấy, mô hình trước tiên tạo truy vấn SQL tuân thủ ngữ pháp, sau đó thực thi hàm để lấy dữ liệu doanh số. Cuối cùng, GPT-5 chuyển dữ liệu đó thành phần tóm tắt ngôn ngữ tự nhiên, xếp hạng rõ ràng theo doanh số tháng trước theo danh mục.
=== 1) First Model Call ===
Raw model output objects:
 [ResponseReasoningItem(id='rs_6897acee8afc819f9e7ae0f675bfa4ee0d5175a46255063b', summary=[], type='reasoning', content=None, encrypted_content=None, status=None), ResponseCustomToolCall(call_id='call_vzcHPT7EGvb7QbhF2djVIJZA', input='SELECT category, SUM(sales) AS total_sales FROM orders WHERE order_month = "2025-07" GROUP BY category ORDER BY total_sales DESC', name='sql_query_runner', type='custom_tool_call', id='ctc_6897acf67a34819f84a085191e4ca1fb0d5175a46255063b', status='completed')]

Extracted SQL from tool call:
 SELECT category, SUM(sales) AS total_sales FROM orders WHERE order_month = "2025-07" GROUP BY category ORDER BY total_sales DESC

=== 2) Local Tool Execution ===
category   | total_sales
----------------------------
Electronics | 52423
Clothing    | 59976
Furniture   | 172713
Toys        | 69667
Books       | 14633

=== 3) Second Model Call ===

Final natural-language answer:
 Here are the total sales by category for last month (2025-07):

- Furniture: 172,713
- Toys: 69,667
- Clothing: 59,976
- Electronics: 52,423
- Books: 14,633

Want this as a chart or need a different month?Tham số mới allowed_tools cho phép bạn định nghĩa một tập con công cụ mà mô hình có thể dùng từ bộ công cụ đầy đủ của bạn. Bạn có thể đặt chế độ auto (mô hình có thể chọn) hoặc required (mô hình phải dùng một công cụ). Điều này cải thiện tính an toàn, khả năng dự đoán và bộ nhớ đệm prompt bằng cách ngăn mô hình gọi các công cụ ngoài ý muốn, đồng thời vẫn cho phép nó chọn phương án tốt nhất trong tập công cụ cho phép.
Bộ công cụ đầy đủ gồm cả get_weather và send_email, nhưng chúng tôi chỉ cho phép get_weather và đặt chế độ "required", buộc mô hình sử dụng nó.
Khi được hỏi “Thời tiết ở Oslo thế nào?”, GPT‑5 trả lời bằng một lời gọi hàm tới get_weather với tham số đúng {"city": "Oslo"}.
from openai import OpenAI

client = OpenAI()

# Full toolset (N)

tools = [
    {
        "type": "function",
        "name": "get_weather",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
    {
        "type": "function",
        "name": "send_email",
        "parameters": {
            "type": "object",
            "properties": {"to": {"type": "string"}, "body": {"type": "string"}},
            "required": ["to", "body"],
        },
    },
]

# Allowed subset (M < N), mode=required  → must call get_weather

resp = client.responses.create(
    model="gpt-5",
    input="What's the weather in Oslo?",
    tools=tools,
    tool_choice={
        "type": "allowed_tools",
        "mode": "required",  # use "auto" to let it decide
        "tools": [{"type": "function", "name": "get_weather"}],
    },
)
for item in resp.output:
    if getattr(item, "type", None) in ("function_call", "tool_call", "custom_tool_call"):
        print("Tool name:", getattr(item, "name", None))
        print("Arguments:", getattr(item, "arguments", None))
Kết quả:
Tool name: get_weather
Arguments: {"city":"Oslo"}Preamble là các lời giải thích ngắn, hiển thị cho người dùng mà GPT-5 có thể tạo ra trước khi gọi công cụ, nhằm giải thích lý do gọi công cụ đó. Điều này tăng tính minh bạch, sự tin cậy và dễ dàng gỡ lỗi, đặc biệt trong các quy trình phức tạp. Chỉ cần hướng dẫn mô hình “giải thích trước khi gọi công cụ”, bạn có thể khiến tương tác trở nên giống con người và có chủ đích hơn mà không thêm nhiều độ trễ.
Trong đoạn mã dưới đây, chúng tôi định nghĩa công cụ hàm get_weather và thêm hướng dẫn hệ thống yêu cầu mô hình xuất một câu ngắn, hiển thị cho người dùng với tiền tố "Preamble:" trước khi gọi công cụ.
Khi được hỏi “Thời tiết ở Oslo thế nào?”, GPT‑5 trước tiên tạo một preamble giải thích rằng nó đang kiểm tra dịch vụ thời tiết trực tuyến, rồi gọi công cụ get_weather với tham số đúng {"city": "Oslo"}. Sau khi thực thi công cụ cục bộ và trả kết quả, mô hình đưa ra câu trả lời cuối cùng bằng ngôn ngữ tự nhiên.
from openai import OpenAI
client = OpenAI()


def get_weather(city: str):
    return {"city": city, "temperature_c": 12}

# Tool
tools = [{
    "type": "function",
    "name": "get_weather",
    "description": "Get current temperature for a city.",
    "parameters": {
        "type": "object",
        "properties": {"city": {"type": "string"}},
        "required": ["city"],
        "additionalProperties": False
    },
    "strict": True,
}]

# Messages (enable preamble via system instruction)
msgs = [
    {"role": "system", "content": "Before you call a tool, explain why you are calling it in ONE short sentence prefixed with 'Preamble:'."},
    {"role": "user", "content": "What's the weather in Oslo?"}
]

# 1) Model call → expect a visible preamble + a tool call
resp = client.responses.create(model="gpt-5", input=msgs, tools=tools)
print("=== First response objects ===")
for item in resp.output:
    t = getattr(item, "type", None)
    if t == "message":  # preamble is a normal assistant message
        print("PREAMBLE:", getattr(item, "content", None))
    if t in ("function_call","tool_call","custom_tool_call"):
        print("TOOL:", getattr(item, "name", None))
        print("ARGS:", getattr(item, "arguments", None))
tool_call = next(x for x in resp.output if getattr(x, "type", None) in ("function_call","tool_call","custom_tool_call"))
msgs += resp.output  # keep context

# 2) Execute tool locally (fake)
import json
args = json.loads(getattr(tool_call, "arguments", "{}"))
city = args.get("city", "Unknown")
tool_result = get_weather(city)

# 3) Return tool result
msgs.append({"type": "function_call_output", "call_id": tool_call.call_id, "output": json.dumps(tool_result)})

# 4) Final model call → natural answer
final = client.responses.create(model="gpt-5", input=msgs, tools=tools)
print("\n=== Final answer ===")
print(final.output_text)
Như thấy, mô hình trước hết đưa ra preamble ngắn giải thích ý định, sau đó gọi đúng công cụ get_weather với {"city": "Oslo"}, và cuối cùng trả về nhiệt độ bằng ngôn ngữ tự nhiên.
=== First response objects ===
PREAMBLE: [ResponseOutputText(annotations=[], text='Preamble: I'm checking a live weather service to get the current conditions for Oslo.', type='output_text', logprobs=[])]
TOOL: get_weather
ARGS: {"city":"Oslo"}

=== Final answer ===
It's currently about 12°C in Oslo.GPT-5 được thiết kế để phát huy hiệu quả với prompt được biên soạn tốt, và OpenAI cung cấp Prompt Optimizer để giúp bạn tinh chỉnh. Công cụ này tự động điều chỉnh prompt theo phong cách suy luận của GPT-5, cải thiện độ chính xác và hiệu quả.
Truy cập Edit prompt - OpenAI API và viết một prompt đơn giản, chẳng hạn “Tạo ứng dụng web bản sao Netflix.” Công cụ sẽ phân rã prompt của bạn thành cấu trúc chi tiết, tối ưu cho mô hình GPT-5.
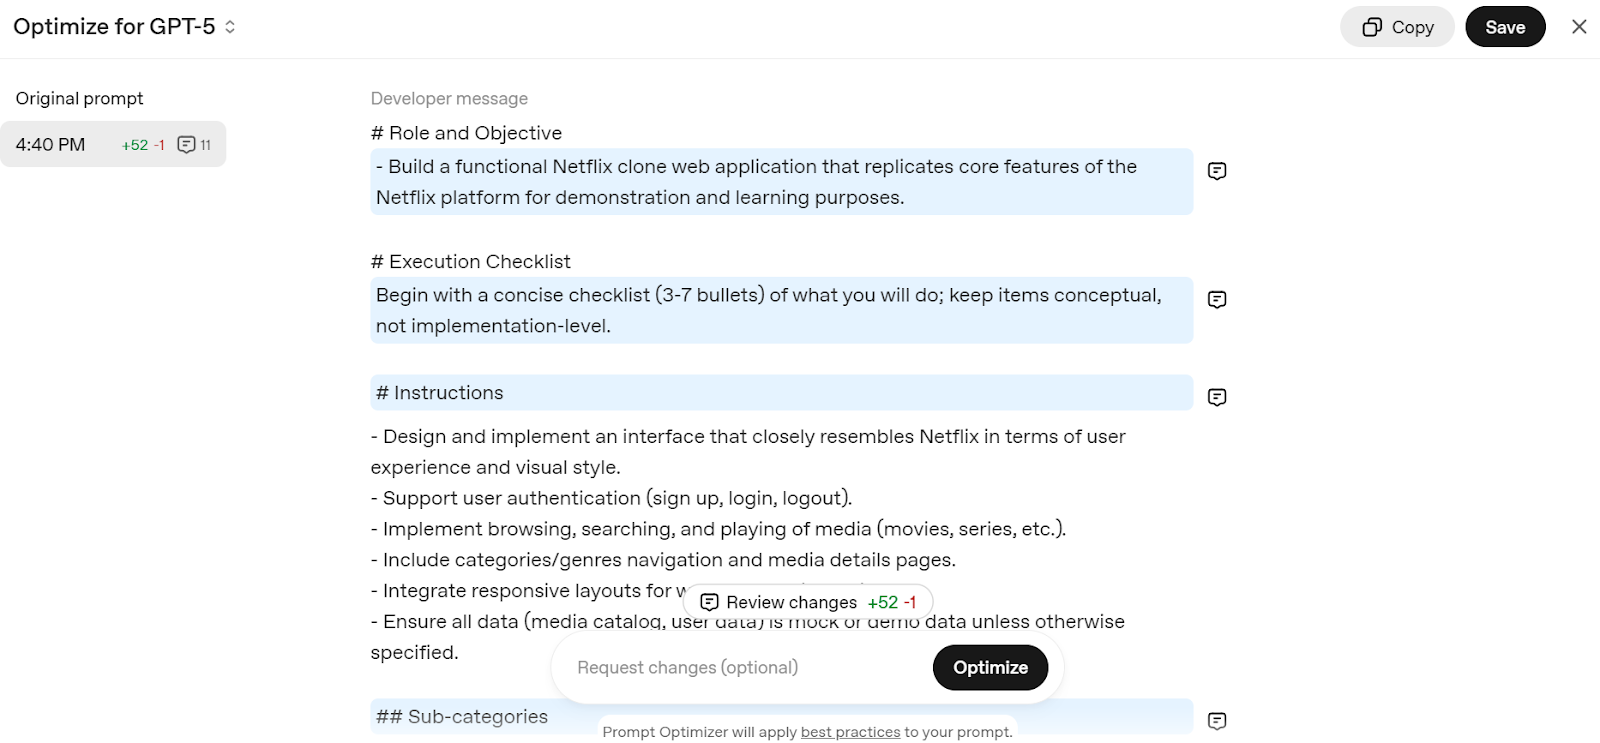
Nguồn: Prompt Optimizer
Chỉ cần sao chép prompt và dán vào ChatGPT để bắt đầu xây dựng dịch vụ web Netflix của riêng bạn.
OpenAI khuyến nghị mạnh mẽ các nhà phát triển chuyển từ các mô hình cũ sang họ GPT‑5 mới để giảm chi phí, cải thiện độ chính xác và nâng cao chất lượng phản hồi.
Việc di chuyển rất đơn giản; chỉ cần làm theo bảng dưới đây để chọn đúng mô hình GPT‑5 và mức suy luận phù hợp với trường hợp sử dụng của bạn.
|
Mô hình hiện tại |
Mô hình GPT-5 khuyến nghị |
Mức suy luận khởi điểm |
Ghi chú di chuyển |
|
o3 |
GPT-5 |
Medium |
Bắt đầu với mức suy luận medium + tinh chỉnh prompt; tăng lên high nếu cần. |
|
gpt-4.1 |
GPT-5 |
Minimal |
Bắt đầu với mức minimal + tinh chỉnh prompt; tăng lên low để có hiệu năng tốt hơn. |
|
o4-mini |
GPT-5-mini |
Medium |
Dùng GPT-5-mini kèm tinh chỉnh prompt. |
|
gpt-4.1-mini |
GPT-5-mini |
Minimal |
Dùng GPT-5-mini kèm tinh chỉnh prompt. |
|
gpt-4.1-nano |
GPT-5-nano |
Minimal |
Dùng GPT-5-nano kèm tinh chỉnh prompt. |
GPT-5 không chỉ là một mô hình thông minh hơn; đó là một bộ công cụ dành cho nhà phát triển để xây dựng hệ thống AI thông minh, đáng tin cậy và hiệu quả. Với khả năng điều khiển tinh vi mức suy luận, độ dài trả lời, việc sử dụng công cụ và định dạng đầu ra, nó thích ứng từ tác vụ viết mã nhanh cho đến quy trình nhiều bước phức tạp.
Bằng cách tận dụng các tính năng mới và thực tiễn tốt nhất, bạn có thể phát triển ứng dụng AI sẵn sàng cho sản xuất với OpenAI SDK chỉ với nỗ lực tối thiểu.
Nếu bạn mới bắt đầu làm việc với OpenAI, hãy xem các tài nguyên dưới đây:
Các khóa học hàng đầu về OpenAI
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
